Что выпустили
22 сентября проект vLLM опубликовал версию 0.30.0 своего открытого сервера инференса. Это обновление программного стека, а не выпуск новой базовой модели. Среди изменений — Fast Start: отдельный процесс удерживает подготовленные веса модели в памяти GPU, чтобы после перезапуска движка подключить их через CUDA IPC вместо повторной загрузки с диска. В релизе также заявлена поддержка новых семейств моделей и опубликованы образы для разных платформ.
Практическое следствие
Для компании, которая уже обслуживает внутренний RAG или ИИ-агентов через vLLM, главный вопрос — сколько длится возврат сервиса после обновления или сбоя. Fast Start может сократить именно этот простой при частых перезапусках и большой модели. Он не ускоряет каждый запрос автоматически и не делает GPU дешевле: удерживаемые веса занимают видеопамять, а результат зависит от конкретного оборудования и конфигурации. Для малого пилота на одной карте без частых рестартов выигрыш может не окупить дополнительную сложность.
Важны и совместимость с текущей установкой. По примечаниям к релизу, обычный `vllm serve` теперь включает масштабируемые конечные точки только с флагом `--enable-scale-out`; прежняя переменная `VLLM_ENABLE_SCALE_OUT_ENDPOINTS` заменена. Изменения затрагивают также отдельные варианты GPTQ и YaRN. Это повод проверить конфигурацию до обновления, а не считать релиз заменой модели или гарантией роста производительности.
Что проверить перед установкой
- Зафиксировать текущую версию, образ контейнера, модель и параметры запуска; обновление сначала прогнать на тестовом контуре.
- Измерить время холодного и повторного старта, p95 задержки и доступную память GPU на своих рабочих запросах. Публикуемые улучшения на H200 нельзя переносить на другую карту.
- Проверить работу аутентификации, маршрутизации и масштабируемых конечных точек после смены флагов; подготовить откат к прежнему образу.
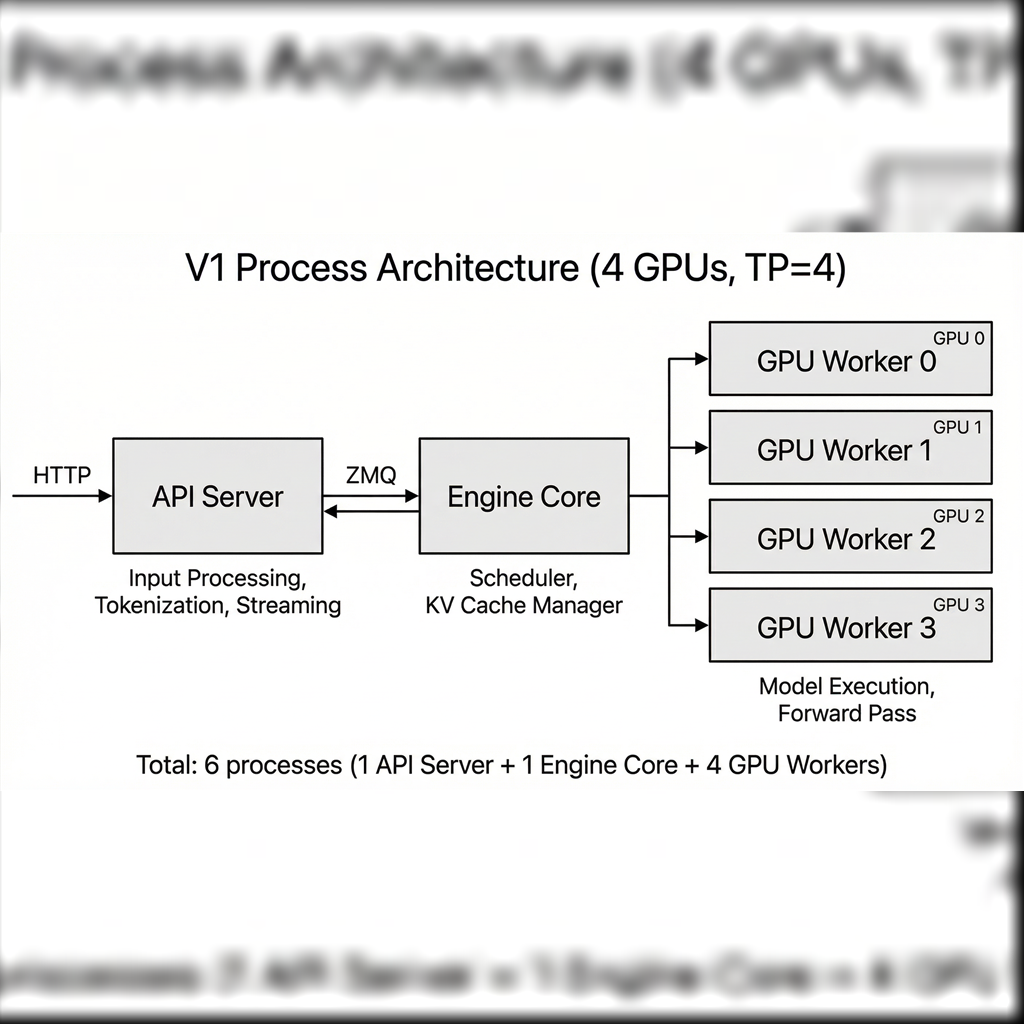
В официальном релизе есть образы CUDA 13.0 и 12.9, ROCm, CPU и XPU. Выбор сборки зависит от платформы. Независимый обзор Local Model Watch подтверждает дату выпуска и выделяет Fast Start, но не заменяет измерения на своём сервере. На обложке — официальная схема многопроцессной архитектуры vLLM, а не схема нового механизма Fast Start; изображение из репозитория проекта под Apache-2.0 размещено поверх размытого продолжения того же исходника для квадратного формата.