Что вышло
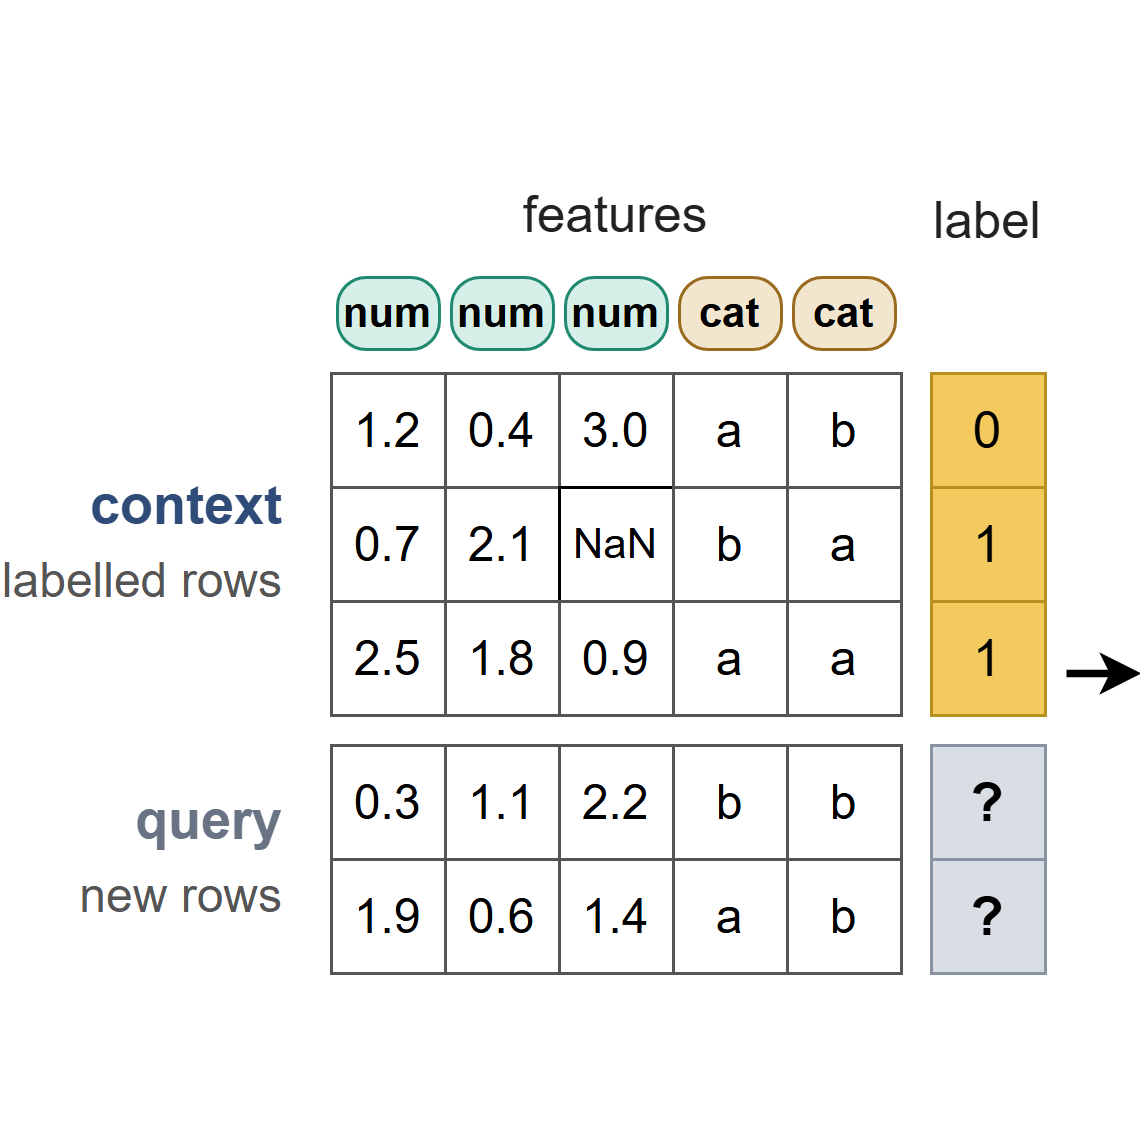
29 сентября NVIDIA представила Kumo Tabular — модель для прогнозов по таблицам. Официальные веса трёх размеров размещены в Hugging Face, а код библиотеки `structured-data-models` открыт на GitHub. Модель получает строки с известным результатом как контекст и предсказывает класс или численное значение для новых строк без обучения отдельной модели на каждом новом наборе данных. Это не чат-бот и не генератор отчётов: речь о табличной классификации и регрессии.
Для малого бизнеса практический сценарий — проверить, можно ли быстрее построить прогноз по уже накопленным записям CRM, заказам или обращениям: например, вероятность задержки заказа или отказа клиента. Нужны исторические строки с достоверной целевой меткой, а не просто выгрузка всех полей из Excel. Отдельные персональные данные не стоит включать без необходимости.
Что подтверждено и что ещё предстоит доказать
В карточке модели доступны каталоги `small`, `medium` и `large`; NVIDIA указывает диапазон 28–215 млн параметров. Код репозитория распространяется по Apache 2.0, веса — по OpenMDW 1.1, допускающей коммерческое использование при соблюдении условий. Это разные лицензии; при распространении весов нужно сохранить текст лицензии и уведомления об авторстве. Пример запуска в карточке использует CUDA, а библиотека в официальной документации описана как GPU-native. Не стоит обещать работу на офисном ноутбуке без проверки конкретной конфигурации.
NVIDIA сообщает о высоких результатах на нескольких открытых бенчмарках. Это заявление разработчика, а не измеренная окупаемость для российского предприятия. Независимая работа TabArena показывает, что градиентный бустинг остаётся сильным конкурентом на практических табличных задачах. В самом объявлении NVIDIA предупреждает: качество может снижаться, если новые строки отличаются от обучающих или таблица выходит далеко за типичные диапазоны. Базовое сравнение с CatBoost или другим привычным методом на собственном отложенном периоде обязательно.
Быстрый управленческий вывод
Kumo Tabular интересна как дополнительный кандидат в пилоте, когда уже есть размеченная история и доступна подходящая GPU-инфраструктура. Сравните не рекламный рейтинг, а качество на свежем отложенном месяце, калибровку вероятностей, стоимость запуска и время аналитика. Если метки нет или процесс изменился, новая модель не создаст из данных надёжный прогноз сама по себе. Официальная схема на обложке показывает вход: строки с известными метками и строки, для которых нужен прогноз.