Задача: ускорить ввод документов, не потеряв контроль
Счета, накладные и акты выглядят удобной задачей для мультимодальной модели: загрузить PDF, попросить вернуть JSON и записать результат в учётную систему. На демонстрации это действительно работает. В промышленном процессе опасность начинается там, где вероятностный ответ становится бухгалтерским фактом без независимой проверки.
Ошибки здесь не абстрактны. Перепутанная дата меняет период учёта, неверный ИНН связывает документ не с тем контрагентом, пропущенная строка искажает сумму, а уверенно выдуманный номер договора создаёт ложное основание для проводки. Поэтому архитектуру стоит строить не вокруг «умной модели», а вокруг доказуемого маршрута данных.
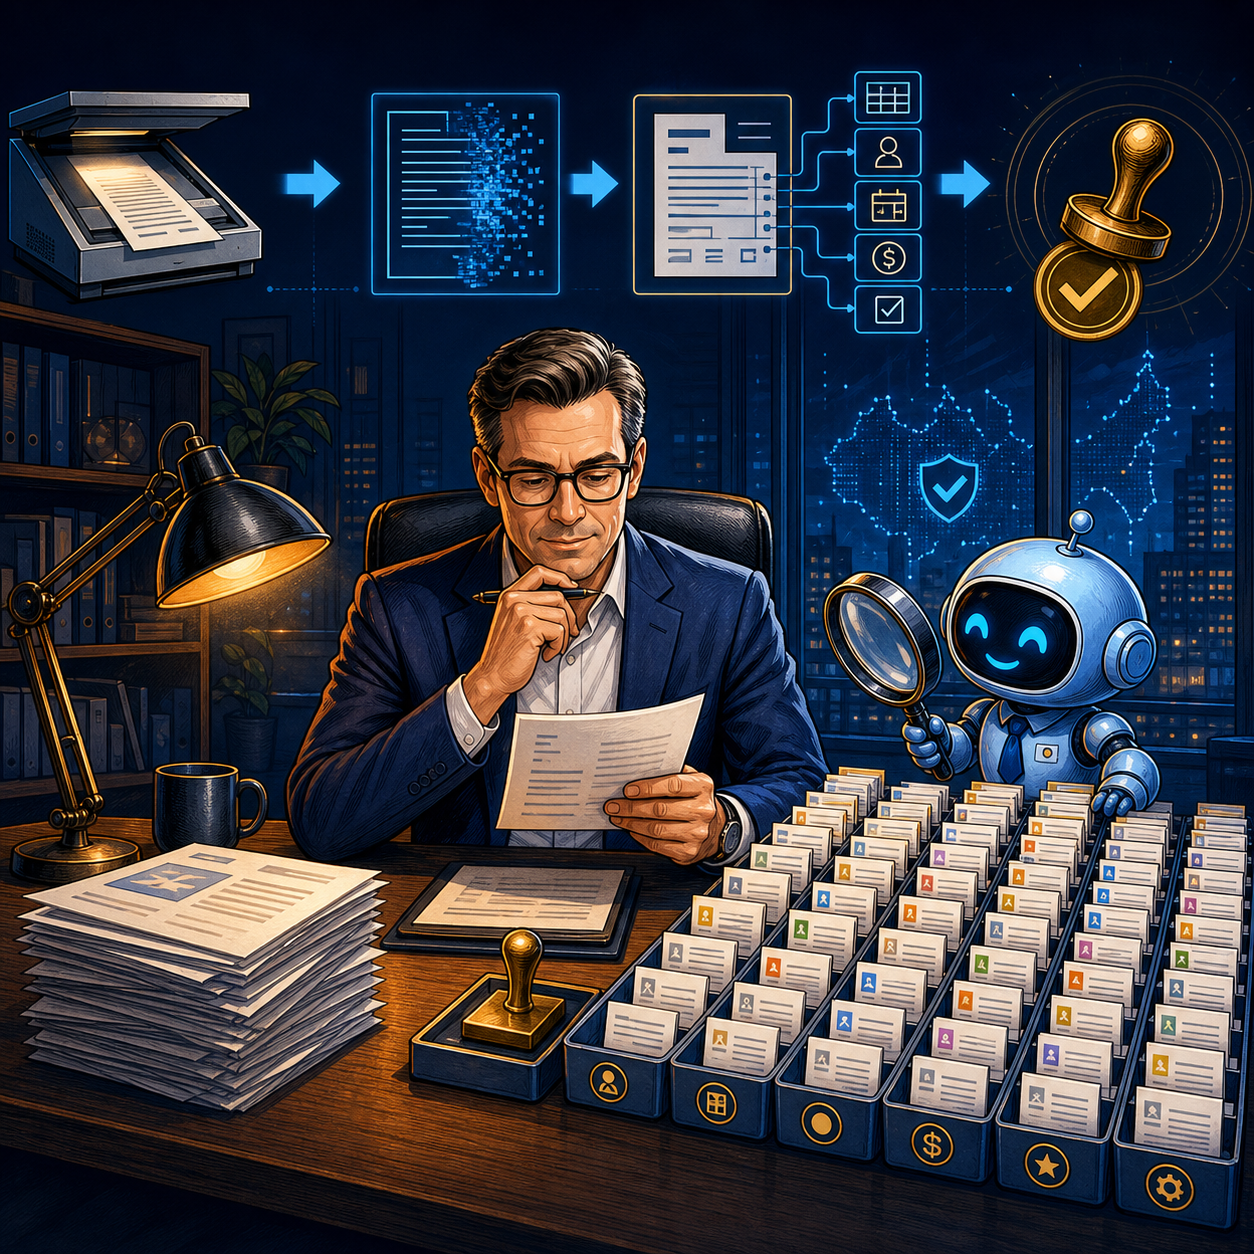
Практичный локальный контур разделяет пять функций:
- приём и карантин файла;
- извлечение текста, таблиц и координат;
- нормализация полей в строгую схему;
- детерминированные проверки по справочникам и арифметике;
- подтверждение человеком перед записью в 1С, ERP или ЭДО.
ИИ ускоряет чтение и предлагает структуру. Правила проверяют то, что можно проверить однозначно. Сотрудник принимает решение там, где цена ошибки выше стоимости ручного просмотра.
Почему одного VLM-вызова недостаточно
Визуально-языковая модель умеет учитывать расположение блоков и смысл документа, но генерирует ответ вероятностно. NIST отдельно относит к рискам генеративного ИИ конфабуляции: система может уверенно выдать неверное содержание. Для финансового документа это означает, что синтаксически корректный JSON ещё не является достоверной записью.
Есть и более приземлённые причины ошибок:
- скан повернут, смят или снят под углом;
- печать перекрывает реквизит;
- таблица продолжается на следующей странице;
- у поставщика нестандартный порядок колонок;
- в PDF есть текстовый слой, но он повреждён;
- десятичный разделитель, пробелы и обозначение валюты распознаны неодинаково;
- модель «исправляет» незнакомый артикул на похожее слово.
Поэтому результат нужно хранить вместе с происхождением: номер страницы, координаты блока, исходный фрагмент, версия распознавателя, уровень уверенности и применённые правила. Тогда оператор видит не только поле «итого», но и место, откуда оно взялось.
Слой 1. Приём и карантин
Документ поступает из электронной почты, ЭДО, папки сканера или личного кабинета. До распознавания следует:
1. присвоить внутренний идентификатор;
2. вычислить хеш файла для защиты от повторной обработки;
3. проверить тип, размер и возможность открыть документ;
4. выполнить антивирусную проверку;
5. сохранить оригинал в неизменяемом хранилище;
6. отделить неизвестные и повреждённые файлы в карантин.
Эта часть не требует ИИ. Она создаёт трассируемость и не позволяет одному вложению незаметно превратиться в несколько проводок. Входной сервис не должен иметь права менять справочники или создавать платёж.
Для локального контура достаточно объектного хранилища, очереди заданий и метаданных в PostgreSQL. Если документы содержат персональные данные, цены или коммерческие условия, доступ к оригиналам и производным изображениям нужно разделять ролями и журналировать.
Слой 2. Парсинг документа
Сначала полезно определить, есть ли в PDF качественный текстовый слой. Если он сохранён, извлечение текста обычно быстрее и дешевле рендеринга каждой страницы в изображение. OCR нужен для сканов, фотографий и повреждённых PDF; VLM — для сложной компоновки или неоднозначных фрагментов.
Открытые инструменты позволяют запускать эту часть локально. PP-StructureV3 в PaddleOCR объединяет обнаружение макета, OCR, распознавание таблиц и дополнительные модули для ориентации, выравнивания, печатей, формул и диаграмм. Компоненты можно включать отдельно, поэтому для накладной не обязательно запускать весь набор.
Docling преобразует PDF, офисные файлы и изображения в унифицированное представление, сохраняет порядок чтения и структуру таблиц, экспортирует результат в JSON или Markdown и поддерживает локальное выполнение, включая изолированные среды. Код Docling распространяется по MIT, но лицензии подключаемых моделей следует проверять отдельно.
На выходе этого слоя нужен не окончательный бухгалтерский объект, а нейтральная модель документа:
- страницы и их размеры;
- текстовые блоки с координатами;
- таблицы с ячейками и связями строк и колонок;
- изображения и печати как отдельные элементы;
- исходные значения без «исправлений по смыслу»;
- диагностические показатели качества.
Слой 3. Извлечение в строгую схему
Следующий сервис переводит нейтральный документ в версионируемую бизнес-схему. Для счёта она может включать тип документа, номер и дату, продавца, покупателя, валюту, строки товаров, НДС, итог и ссылку на договор.
Каждое поле лучше представлять не одной строкой, а объектом:
- `raw_value` — что распознано буквально;
- `normalized_value` — дата, число или идентификатор в стандартном формате;
- `page` и `bounding_box` — откуда взялось значение;
- `method` — правило, OCR или VLM;
- `confidence` — оценка компонента;
- `warnings` — неоднозначность и нарушенные ограничения.
VLM здесь полезна как резервный интерпретатор: связать подпись с соседним значением, понять нестандартную таблицу или классифицировать документ. Но модель должна получать строгую JSON-схему и право вернуть `null`, а не обязанность заполнить всё. Отсутствующее значение безопаснее выдуманного.
Слой 4. Детерминированная проверка
До участия бухгалтера система может отсеять большую часть очевидных ошибок обычным кодом.
Минимальный набор проверок:
- сумма строк совпадает с итогом с учётом допустимого округления;
- НДС согласован со ставками и базой;
- валюта входит в разрешённый справочник;
- ИНН и другие идентификаторы проходят форматную и контрольную проверку;
- контрагент найден в мастер-данных;
- номер и дата не дублируют уже принятый документ;
- договор принадлежит найденному контрагенту и действовал на дату документа;
- заказ или поставка существуют, а количество не превышает согласованный допуск;
- обязательные поля заполнены;
- значения не были взяты только из низкоуверенного фрагмента.
Проверка должна выдавать не один «процент доверия», а причины: `TOTAL_MISMATCH`, `UNKNOWN_VENDOR`, `DUPLICATE_DOCUMENT`, `LOW_CONFIDENCE_TAX_ID`. Такой список можно тестировать, объяснять и использовать для маршрутизации.
Важно не смешивать бизнес-правило и ответ модели. Если сумма не сходится арифметически, ещё один запрос к VLM не делает документ правильным. Он может предложить альтернативное чтение спорной ячейки, но итог снова должен пройти то же правило.
Слой 5. Человеческое подтверждение и запись
Интерфейс проверки показывает оригинал и извлечённые поля рядом. При выборе поля подсвечивается соответствующий участок страницы. Ошибочные или низкоуверенные значения выводятся первыми, а корректные повторяющиеся поля не требуют полного повторного чтения документа.
Полезно ввести три маршрута:
- автоматическая подготовка черновика при полном прохождении правил;
- обязательная проверка конкретных полей при предупреждениях;
- полный ручной разбор при неизвестном шаблоне, повреждении или критическом несоответствии.
Даже «зелёный» документ на первом этапе лучше записывать как черновик, а не как проведённую операцию. Право финальной записи принадлежит отдельному сервису с минимальными полномочиями. Он принимает только подтверждённый объект, сохраняет идентификатор операции и защищается от повторного вызова тем же ключом.
Исправления оператора становятся размеченными данными, но не должны автоматически переобучать модель. Сначала их очищают от персональных данных, проверяют качество разметки, группируют по типам документов и версионируют.
Как измерять качество
Средняя точность OCR мало говорит о готовности процесса. Исследования по извлечению данных из счетов предлагают измерять точность на уровне полей, exact match и провалы проверок согласованности. Для бизнеса нужно добавить операционные метрики.
Минимальный набор для пилота:
- exact match для номера, даты, ИНН, валюты и итоговой суммы;
- точность строк таблицы и доля пропущенных строк;
- доля документов, прошедших правила без предупреждений;
- доля полей, исправленных оператором;
- медианное время проверки одного документа;
- ложные дубли и пропущенные дубли;
- число попыток записи, заблокированных идемпотентностью;
- стоимость обработки документа по типам и страницам.
Критичные поля нужно оценивать отдельно. Ошибка в комментарии и ошибка в сумме не равны. Контрольную выборку следует собирать из реальных поставщиков: хорошие PDF, сканы, фотографии, многостраничные таблицы, печати, рукописные пометки и редкие шаблоны.
Локальная инфраструктура
Для пилота на нескольких тысячах страниц в месяц можно начать с одного сервера приложений и отдельного GPU-узла только для тяжёлых моделей. Базовый OCR и правила часто работают на CPU; производительность зависит от разрешения, числа модулей и качества входа. Документация PaddleOCR прямо предупреждает, что лишние компоненты можно отключать и выбирать более лёгкие модели при нехватке памяти или низкой скорости.
Практичная схема:
1. API приёма и объектное хранилище оригиналов.
2. Очередь, разделяющая быстрые PDF и тяжёлые сканы.
3. Воркеры Docling или PaddleOCR без доступа к учётной системе.
4. Сервис нормализации и правил в отдельном контейнере.
5. PostgreSQL для метаданных, версий и аудита.
6. Интерфейс оператора.
7. Изолированный коннектор к 1С или ERP с правом создавать только черновики.
Модели и контейнеры следует фиксировать по версиям, а обновление прогонять на золотом наборе до переноса в производство. Локальность защищает данные от внешней передачи, но не решает сама по себе управление доступом, резервное копирование и уязвимости цепочки поставки.
Модельная экономика
Предположим, компания обрабатывает 4 000 документов в месяц. Ручной ввод и проверка занимают в среднем шесть минут, то есть 400 часов. После внедрения система не устраняет проверку, но сокращает её до двух минут для 75% документов; остальные 25% остаются на шести минутах.
Тогда трудозатраты составят 200 часов: 3 000 документов × 2 минуты плюс 1 000 × 6 минут. Освобождается 200 часов в месяц. При полной стоимости часа 900 рублей модельный ресурсный эффект равен 180 000 рублей.
Допустим, инфраструктура и сопровождение стоят 70 000 рублей в месяц, а пилот и интеграция — 1,2 млн рублей. Модельный чистый эффект составит 110 000 рублей в месяц, простая окупаемость — около 10,9 месяца.
Это не обещание результата. Нужно подставить реальный поток, стоимость часа, долю исключений и цену ошибок. Если сотрудники не сокращаются, высвобождённое время создаёт финансовый эффект только тогда, когда уходит переработка, ускоряется закрытие периода или команда обрабатывает больший объём без найма.
Пилот на четыре недели
Неделя 1: выберите один тип документа и 200–500 обезличенных примеров от разных поставщиков. Утвердите схему и критичные поля.
Неделя 2: разверните локальный парсер, сохраните координаты и соберите базовые метрики. Ничего не записывайте в 1С.
Неделя 3: добавьте арифметику, справочники, поиск дублей и интерфейс проверки. Зафиксируйте причины всех предупреждений.
Неделя 4: проведите теневой прогон рядом с текущим процессом. Сравните время, исправления и критичные ошибки. Только после приёмки подключайте создание черновика через ограниченный коннектор.
Условие масштабирования формулируется заранее, например: не менее 99,5% exact match по итоговой сумме и ИНН на золотом наборе, ноль неподтверждённых записей, сокращение медианного времени проверки минимум на 40% и понятная экономика при фактической доле исключений.
Что взять руководителю
Локальная обработка документов — хороший кандидат для ИИ, если модель не становится единственным источником истины. Рабочая архитектура сохраняет оригинал и координаты, разделяет распознавание и правила, допускает `null`, объясняет каждое исключение и отдаёт право записи отдельному сервису после человеческого подтверждения.
Первый управленческий шаг — не выбор самой большой VLM. Возьмите один тип документа, определите пять критичных полей и соберите золотой набор с реальными исключениями. Если система не может показать источник каждого значения и безопасно остановиться при сомнении, подключать её к учёту ещё рано.