Что произошло
13 октября 2026 года команда Hugging Face представила Llama Windows — приложение для Windows 11, которое держит локальную модель под рукой в системном трее. Оно управляет движком llama.cpp: помогает скачать совместимую модель в формате GGUF, запустить её на компьютере и обратиться к ней через локальный API. Исходный код опубликован в репозитории ggml-org/Llama-Windows.
Новость важна не потому, что появилась ещё одна кнопка «поговорить с ИИ». Для небольшой компании это более простой способ проверить сценарий локального вывода на рабочем компьютере без отдельного сервера: например, черновое резюмирование внутренних документов или классификацию обезличенных обращений. Приложение использует стандартный кэш Hugging Face, поэтому уже загруженные модели могут быть доступны другим совместимым инструментам.
Что подтверждено и как проверить
Авторы указывают локальный адрес сервера `http://localhost:9931`. Значит, прототип другого приложения может обращаться к модели через API на той же машине. В официальном репозитории описаны установка, управление моделями и исходный код; это реально доступный стек, а не анонс будущих весов. Llama Windows — оболочка для запуска, а не новая базовая модель: качество ответа, лицензия и требования к памяти зависят от выбранного GGUF-файла.
Для пилота достаточно одного тестового ПК с Windows 11 и набора данных, из которого удалены персональные сведения. Сначала проверьте, что выбранная модель допускает коммерческое применение, затем измерьте время ответа и качество на 30–50 типовых запросах. Если нужна работа с корпоративными документами, отдельно потребуется слой поиска, права доступа и проверка ссылок на источники: само приложение не превращает папку файлов в защищённый RAG.
Ограничение для бизнеса
Локальный запуск не равен готовому корпоративному контуру. Администратору всё ещё нужно контролировать доступ к машине и локальному порту, обновления программы, происхождение весов и хранение данных. Для нескольких сотрудников и устойчивого процесса потребуется отдельная схема развёртывания и мониторинга. Практический следующий шаг — недорогой пилот на одном устройстве с заранее заданными метриками качества, задержки и памяти, а не закупка инфраструктуры по одному скриншоту.
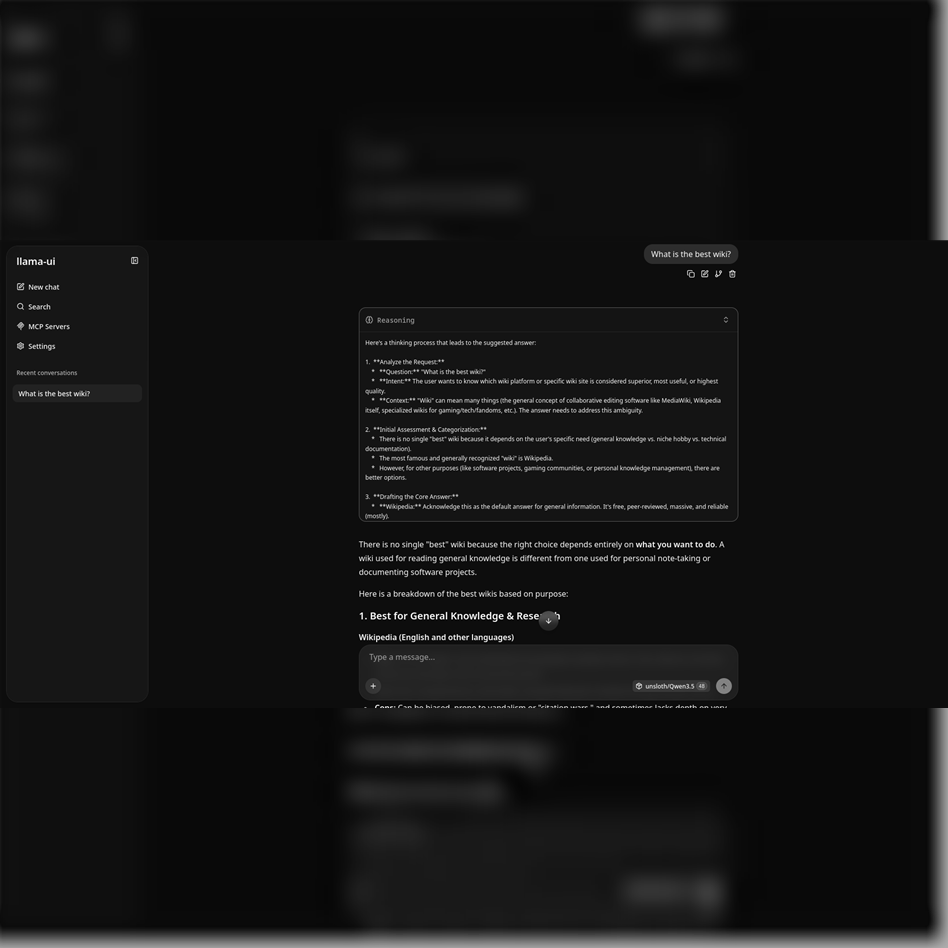
На обложке показан интерфейс llama.cpp из Wikimedia Commons; это иллюстрация используемого движка, а не снимок новой панели Llama Windows. Автор изображения — The ggml authors, лицензия MIT.