Что выпущено
6 октября Google DeepMind представила EmbeddingGemma 2 — открытую модель для построения векторов по тексту и коду, изображениям, аудио и видеокадрам. Это не чат-бот: модель не пишет ответ за сотрудника, а помогает находить похожие материалы разных типов в одном поисковом индексе. Например, текстовый запрос может вернуть нужную фотографию из архива или фрагмент записи.
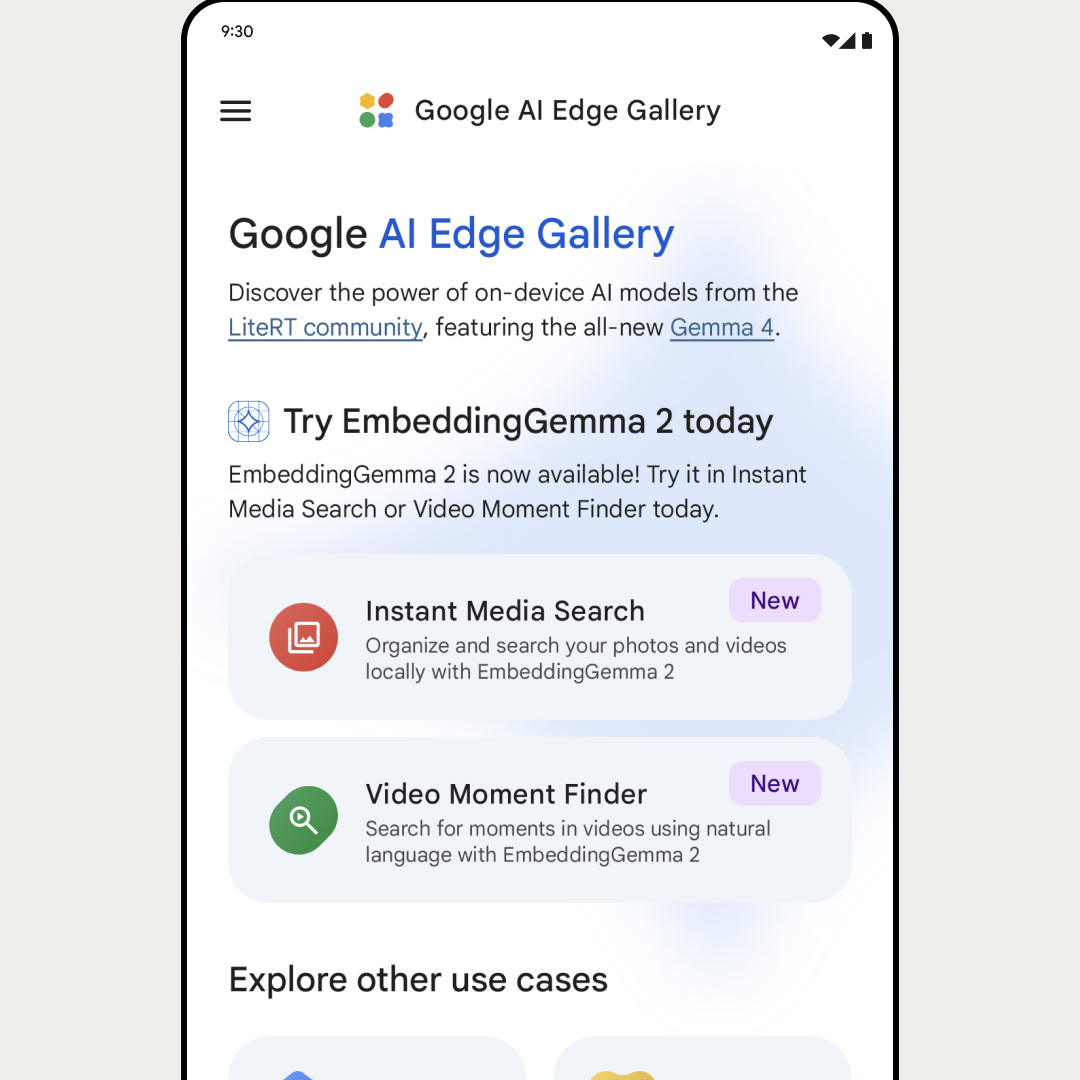
На официальной карточке указаны 740 млн параметров в полной конфигурации, выходной вектор размерности 768 и контекст до 8192 токенов. Текстовый модуль содержит 270 млн параметров; модули зрения и аудио можно подключать отдельно. Веса действительно доступны в официальном репозитории, лицензия — Apache 2.0, допускающая коммерческое применение. Google также показывает работу модели в приложении AI Edge Gallery: локальный поиск по медиатеке и поиск моментов в видео. Это демонстрация продукта, а не измеренный результат для бизнеса.
Практическое следствие
Для небольшой сервисной компании возможный пилот — поиск по фотографиям неисправностей, инструкциям и голосовым заметкам техников без передачи архива во внешний API. Понадобятся разрешённый набор файлов, извлечение кадров и аудио, вычисление векторов, локальный векторный индекс и права доступа к документам. Если нужен ответ с цитатами, к поиску придётся отдельно добавить генеративную модель и проверку источников.
У Google заявлена возможность сокращать векторы до 512, 256 или 128 измерений ради экономии места. Укороченный индекс нельзя автоматически считать равным полному по качеству: запросы и документы должны иметь одну размерность, после усечения требуется повторная нормализация. При замене прежней модели существующий архив обычно нужно заново проиндексировать.
Что проверить до внедрения
Показатели памяти около 191 МБ для текстового режима и 567 МБ для полной модели относятся к квантованному запуску на конкретном Pixel 11 Pro, а не к любому ноутбуку или серверу. В оригинальном файле весов на Hugging Face около 1,49 ГБ; фактические требования зависят от формата, среды и набора модулей. Русские запросы и отраслевые термины нужно испытать на собственных данных, не полагаясь только на заявленные многоязычные тесты.
Разумный первый шаг — взять 100–200 обезличенных файлов и 20 типичных поисковых запросов, сравнить полноту выдачи, задержку и стоимость индекса с текущим способом поиска. Только после этого решать, нужен ли локальный мультимодальный контур.
Источник: [официальное объявление Google DeepMind](https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/).
Обложка: скриншот официального Google AI Edge Gallery, кадрировано редакцией; лицензия репозитория Apache 2.0.