Что изменилось
Проект vLLM выпустил версию 0.31.0 5 октября 2026 года. В примечаниях к релизу указаны два изменения, важные операторам локального ИИ. Параметр `--max-num-active-seqs` отдельно ограничивает число запросов в состоянии RUNNING — независимо от прежнего `max_num_seqs`. Кроме того, передаваемые в каждом запросе `mm_processor_kwargs` и `media_io_kwargs` теперь отклоняются, если сервер не запущен с `--trust-request-mm-kwargs`. Это изменение поведения может затронуть клиентов, которые настраивали обработку изображения или аудио на уровне запроса.
Почему это важно бизнесу
Когда одним сервером одновременно пользуются поддержка, продажи и внутренний поиск, всплеск длинных запросов способен увеличить ожидание для остальных. Новый предел позволяет оператору отдельно управлять допуском запросов к исполнению. Но это не готовая политика приоритета по отделам и не общий лимит входящего трафика: очередь, тайм-ауты и правила отклонения запросов всё равно нужно настроить и измерить. Независимое руководство Google SRE напоминает, что запросы разной длины потребляют разное количество ресурсов, поэтому число запросов в секунду само по себе плохо описывает предел сервиса.
Защита мультимодальных параметров полезна как более строгий режим по умолчанию, но обновление может нарушить существующую интеграцию. Проверять надо не только запуск модели, но и реальные запросы из приложения: изображение, аудио, длинный контекст и несколько одновременных пользователей.
Существенное ограничение
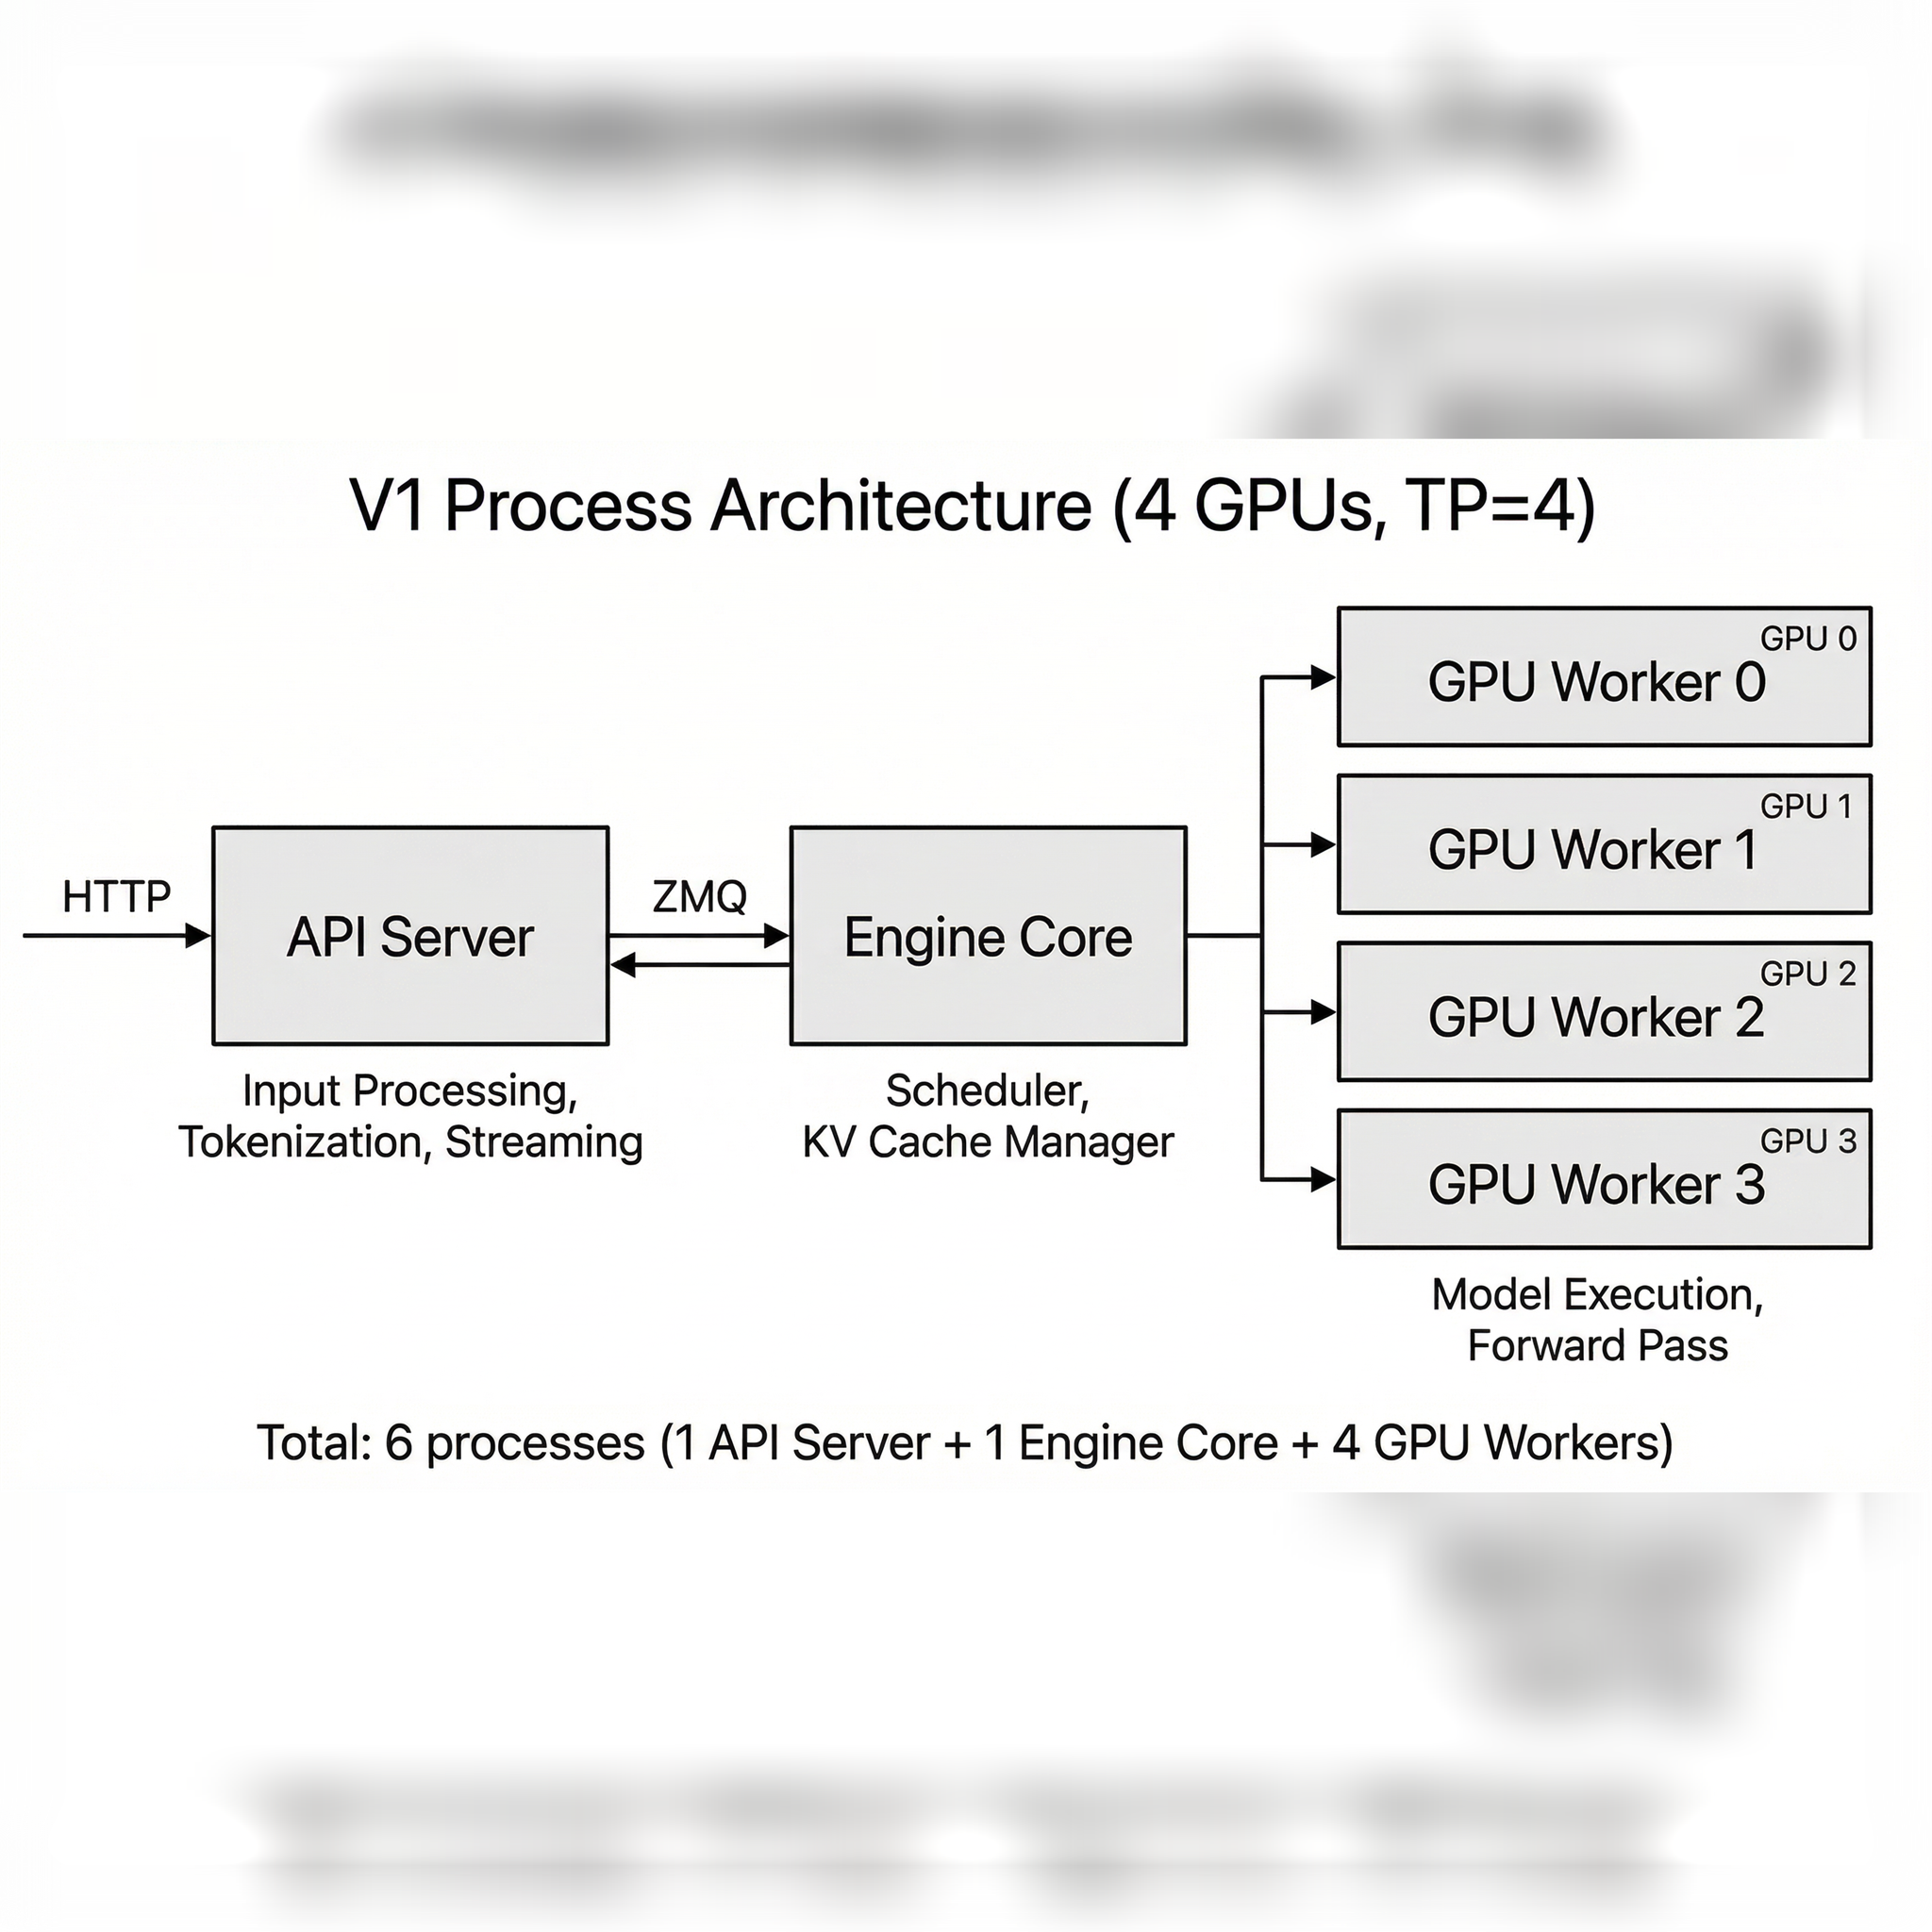
Релиз также перечисляет оптимизации для отдельных крупных моделей и ускорителей. Их нельзя переносить на любой локальный сервер или считать обещанием снижения стоимости. Сначала сравните на своей модели задержку первого токена, время ожидания в очереди, число ошибок и использование памяти до и после обновления. На иллюстрации показана официальная схема vLLM для четырёх GPU — это пример архитектуры, а не требование версии 0.31.0. Первоисточник: примечания к релизу vLLM.