Ускорение, которое меняет границу доверия
Сервер локальной LLM часто обслуживает несколько подразделений, филиалов или клиентов. Чтобы не пересчитывать одинаковое начало длинного запроса, движок может использовать automatic prefix caching: сохранять блоки KV-кэша уже обработанного префикса и повторно использовать их, когда новый запрос начинается с тех же токенов.
Оптимизация особенно полезна для корпоративных сценариев. Большой системный промпт, схема инструментов, политика ответов или типовой документ могут повторяться в сотнях запросов. Кэш сокращает время до первого токена и вычислительную работу, не меняя сам результат модели.
Но общий кэш становится общей технической поверхностью. Если запросы разных доверительных зон используют одно пространство ключей, разница между быстрым попаданием и медленным промахом может выдать сам факт наличия определённого префикса. Исследования timing side channels показывают, что последовательными догадками можно восстанавливать чувствительные части чужих запросов.
Важно не драматизировать механизм. Prefix cache обычно не возвращает пользователю чужой текст напрямую. Риск возникает через побочный сигнал — задержку. Именно поэтому обычной авторизации на API недостаточно, если за одним сервисным ключом скрыты разные клиенты или подразделения.
Как работает prefix cache
При первом запросе движок вычисляет внутренние key-value состояния для блоков входных токенов. Завершённые блоки связываются с хешем, который учитывает предыдущий префикс и содержимое текущего блока. Когда приходит второй запрос с тем же началом, сервер находит совпадающие блоки и продолжает вычисление только с места расхождения.
Это даёт два наблюдаемых режима:
- холодный запрос рассчитывает весь префикс;
- тёплый запрос повторно использует часть KV-кэша и обычно быстрее начинает генерацию.
Если пользователь может отправлять много запросов и достаточно точно измерять время до первого токена, он получает индикатор «такой префикс недавно был в кэше». Один индикатор раскрывает мало. Серия адаптивных догадок способна сузить пространство вариантов.
Наиболее чувствительны многопользовательские контуры, где:
- один сервер обслуживает юридически независимых клиентов;
- филиалы не должны видеть запросы друг друга;
- HR, продажи и юридическая служба используют разные классы данных;
- внешний портал и внутренний помощник делят один inference endpoint;
- API-шлюз использует общий технический ключ для всех пользователей.
Что именно защищает `cache_salt`
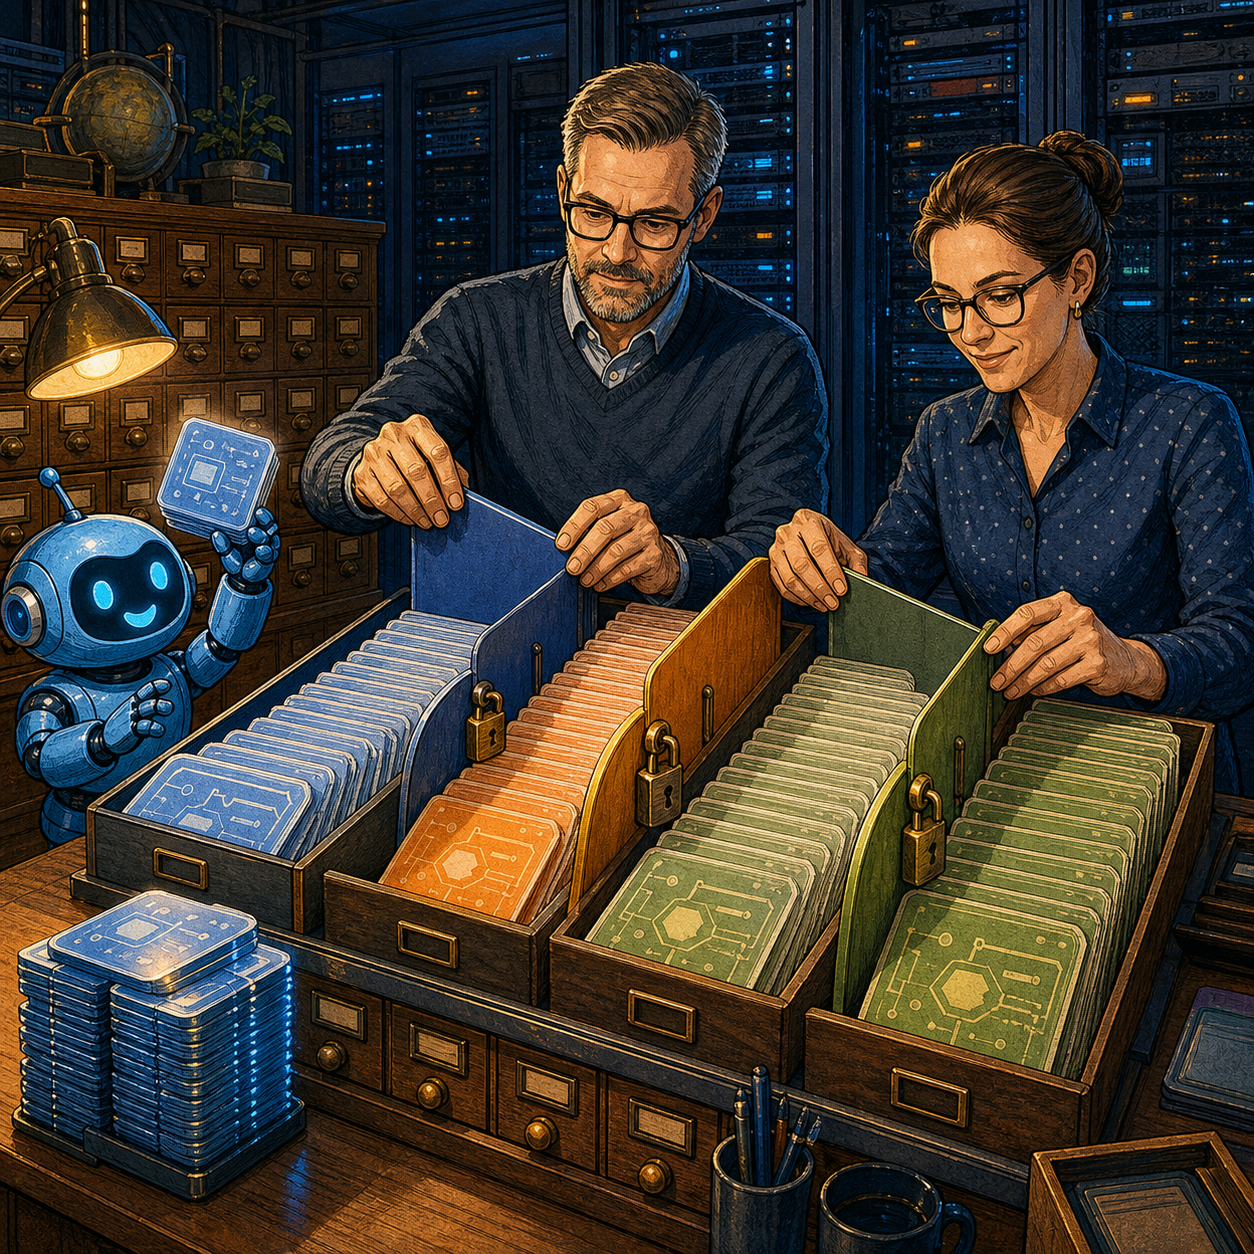
В актуальной архитектуре vLLM можно добавить к запросу `cache_salt`. Значение включается в хеш первого блока, поэтому последующая цепочка кэша совпадает только у запросов с тем же salt. Документация прямо позиционирует этот механизм как изоляцию prefix cache в многопользовательской среде и защиту от атак по разнице задержек.
Управленческий смысл прост: salt задаёт группу, внутри которой повторное использование допустимо.
- один salt на организацию сохраняет кэширование между её сотрудниками;
- отдельный salt на пользователя даёт более строгую изоляцию;
- новый случайный salt для каждого запроса почти исключает повторное использование и сводит выгоду кэша к минимуму;
- глобальный salt для всех возвращает исходную проблему общей зоны.
Salt не является именем клиента. Предсказуемая строка вроде `company-17` не годится, если пользователь может её узнать или подставить. В описании API vLLM рекомендует случайное, достаточно длинное значение, защищённое от третьих лиц.
Правильное место для изоляции — API-шлюз
Клиентское приложение не должно самостоятельно определять свою границу кэша. Иначе злоумышленник сможет запросить salt другой организации или убрать поле. Решение принимает доверенный шлюз после аутентификации.
Минимальная схема:
1. Пользователь проходит аутентификацию на корпоративном API-шлюзе.
2. Шлюз определяет подтверждённый `tenant_id` или класс доступа из серверной сессии.
3. Из закрытого мастер-секрета и идентификатора вычисляется непрозрачное значение, например HMAC.
4. Шлюз принудительно добавляет `cache_salt` и удаляет одноимённое поле, пришедшее от клиента.
5. vLLM принимает запрос только от шлюза, а не из пользовательской сети.
6. Метрики фиксируют запросы без salt как нарушение конфигурации.
Мастер-секрет нельзя передавать в промпт, журналы или клиентский код. Salt не нужен самой модели: он используется движком для адресации кэшированных блоков.
Если у одной организации есть вложенные зоны доверия, например общий справочник и личные вопросы сотрудников, одного salt на весь запрос может быть недостаточно для максимального повторного использования. Без проверенной многоуровневой схемы безопаснее выбрать более строгую границу и принять снижение hit rate.
Хеширование и salt решают разные задачи
Криптографически стойкий хеш уменьшает риск преднамеренных коллизий: ситуации, когда разные блоки получают одинаковый ключ. В документации vLLM указано, что в новых версиях по умолчанию используется SHA-256, а не криптографические алгоритмы могут увеличить риск коллизий и утечки в многопользовательском режиме.
Salt решает другую проблему. Даже идеальный хеш одинакового текста даёт одинаковый результат. Без namespace два клиента с одинаковым префиксом могут попасть в один кэш и наблюдать разницу времени. Поэтому нужны обе меры:
- безопасный алгоритм хеширования для корректности ключей;
- отдельный salt для разделения доверительных зон.
Историческая рекомендация «просто обновить vLLM» необходима, но недостаточна. Обновление закрывает известные ошибки и меняет безопасные значения по умолчанию; архитектуру арендаторов оно за компанию не определяет.
Что `cache_salt` не защищает
Изоляция prefix cache — узкая мера. Она не заменяет:
- авторизацию на API и инструменты агента;
- фильтрацию документов в RAG по правам пользователя;
- разделение журналов, трассировок и аналитики;
- защиту истории диалогов и очередей сообщений;
- шифрование хранилищ и резервных копий;
- управление персональными данными;
- обновление движка и его зависимостей;
- защиту от утечки через другие общие кэши и внешние коннекторы.
Даже при правильном salt сервер всё равно обрабатывает чувствительный запрос. Администратор inference-контура, отладочная трассировка или слишком подробный лог могут иметь доступ к данным другим путём.
Как выбрать уровень изоляции
Один доверенный внутренний процесс
Если endpoint обслуживает только одну команду с едиными правами на одинаковые данные, общий salt на эту группу может быть разумным. Но внешний портал, тестовые аккаунты и сервисные роботы должны быть вынесены из этой зоны.
Несколько подразделений
Salt стоит связывать с классом доступа или подразделением, если политика действительно разрешает обмен промптами внутри этой группы. Название оргструктуры само по себе не доказывает одинаковые права: HR и руководители могут работать с разными наборами данных.
Несколько клиентов
Для SaaS и сервисных бюро минимальная граница — отдельная организация-клиент. Если администраторы клиента не должны видеть пользовательские запросы внутри своей организации, нужна более узкая изоляция.
Особенно чувствительные операции
Для кадровых, медицинских, юридических или расследовательских запросов разумно начать с отдельного salt на пользователя либо отключённого межзапросного кэширования. Производительность можно возвращать после тестов, а не до них.
Проверка перед вводом в эксплуатацию
Одной строки в конфигурации мало. Проведите отрицательный тест с двумя тестовыми арендаторами.
1. Отправьте от арендатора A длинный уникальный префикс несколько раз и убедитесь, что его повтор ускоряется.
2. Отправьте тот же префикс от арендатора B.
3. Проверьте по внутренним метрикам движка, что B не использовал блоки A.
4. Убедитесь, что запрос без salt отвергается шлюзом или получает безопасную изолированную политику.
5. Повторите тест после обновления vLLM, смены адаптера и подключения внешнего KV-cache backend.
Одной задержки недостаточно для приёмки: сеть, очередь и batching создают шум. Используйте внутренний счётчик cache hit вместе с измерением time to first token. В производстве отслеживайте:
- долю запросов с корректной группой salt;
- cache hit rate внутри каждой доверительной зоны;
- p50 и p95 времени до первого токена;
- неожиданные совпадения между тестовыми арендаторами;
- изменения после обновления движка или конфигурации.
Экономика меры
Более строгая изоляция снижает число совпадающих префиксов и может увеличить расход GPU. Но выбор нельзя сводить к «безопасность или скорость». Часто большая часть повторяющегося контекста находится внутри одной организации: её системный промпт, документы и схема инструментов всё равно будут кэшироваться при tenant-level salt.
Сравнивайте три профиля на реальной нагрузке:
- глобальный кэш как небезопасная контрольная точка;
- salt на организацию;
- salt на пользователя.
Для каждого измерьте hit rate, время до первого токена, пропускную способность и стоимость тысячи подтверждённых ответов. Затем выберите самую широкую группу, внутри которой политика действительно разрешает взаимное знание промптов.
Конкретный следующий шаг
Составьте карту всех пользователей одного локального inference endpoint. Для каждой пары ответьте: имеют ли они право знать, что другой пользователь отправлял конкретный префикс? Если нет, они не должны разделять пространство prefix cache.
После этого перенесите формирование `cache_salt` в шлюз, запретите клиентское переопределение, включите криптографическое хеширование, добавьте тест двух арендаторов и только затем сравнивайте производительность.
Главный вывод для руководителя: локальное размещение не делает общий кэш автоматически внутренним и безопасным. Граница доверия должна присутствовать не только в оргструктуре, но и в ключе кэша. Внутрик любит переиспользование; люди решают, кому именно разрешено делиться ускорением.