Что именно выпустила NVIDIA
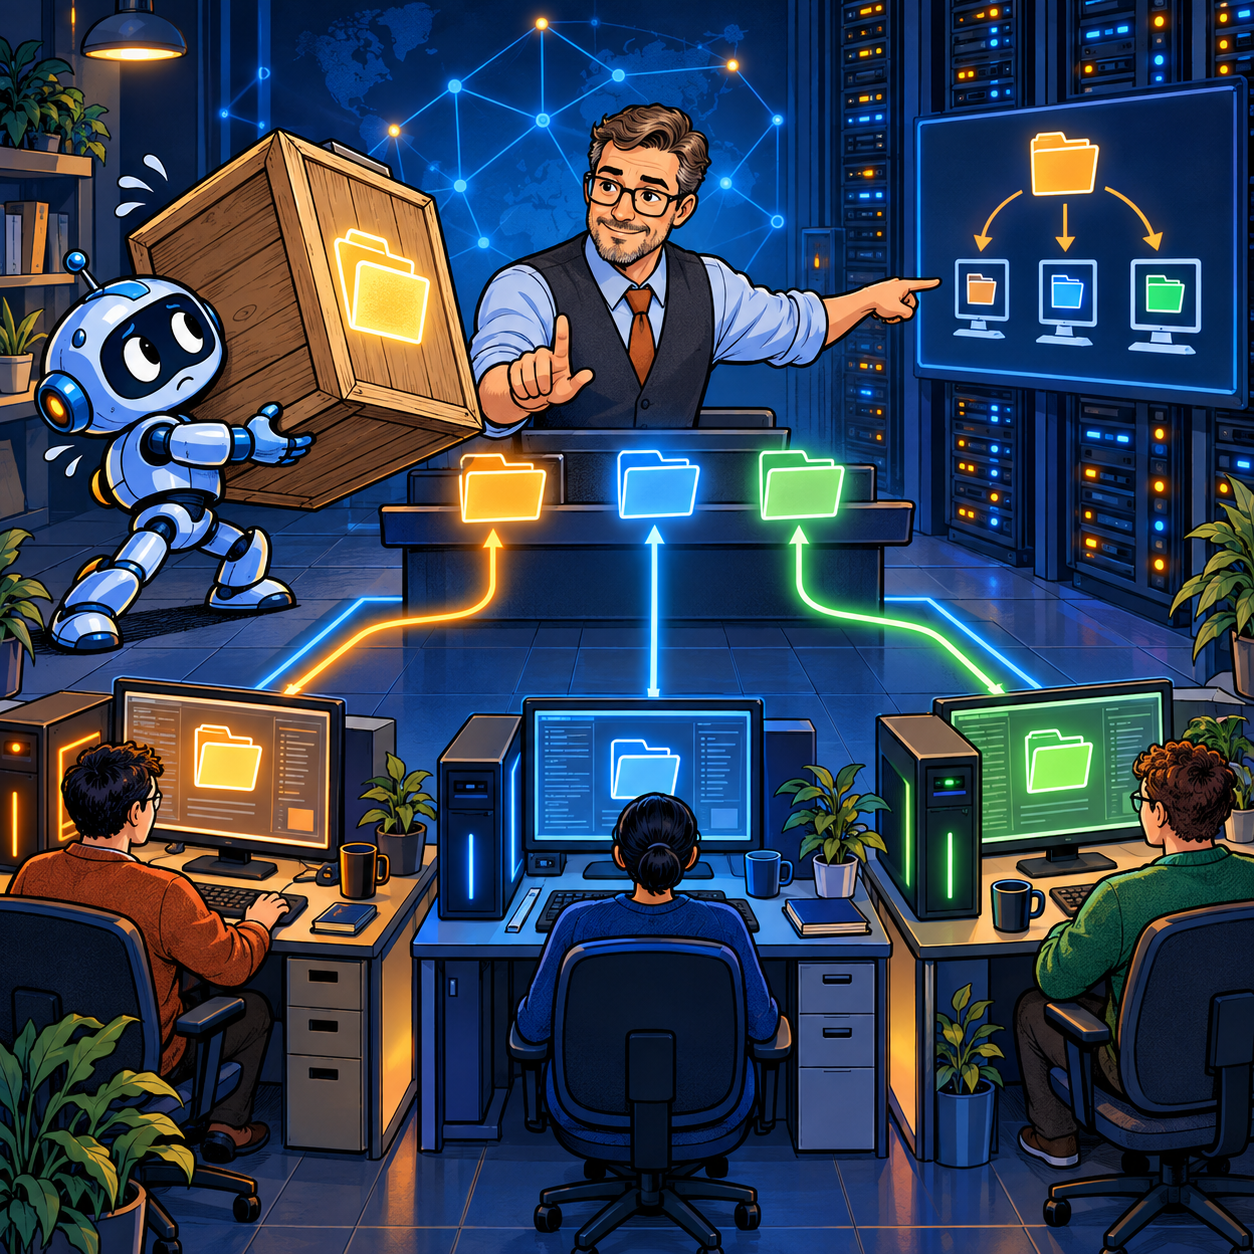
3 сентября 2026 года NVIDIA опубликовала бета-версию Personal AI Router, или PAIR. Это маршрутизатор локального инференса с открытым кодом под лицензией Apache 2.0. Он объединяет в кластер уже имеющиеся компьютеры в одной локальной сети и распределяет между ними независимые запросы к моделям, запущенным через Ollama или LM Studio.
Для прикладной программы PAIR выглядит как локальная точка доступа, совместимая с API Ollama или OpenAI. Приложение отправляет запрос на `localhost`, а маршрутизатор выбирает подходящий узел. Поэтому существующий агентный фреймворк или внутренний сервис часто можно подключить заменой адреса, не переписывая основную логику.
Официально заявлена поддержка Windows 11, Linux и macOS, архитектур x64 и arm64. В документации перечислены GeForce RTX 20-й серии и новее, RTX PRO, DGX Spark и компьютеры Apple с M4 и новее. Но это не означает, что любая модель заработает на любой машине: совместимость движка, формат весов и фактическая доступная память остаются отдельными условиями.
Как проходит один запрос
После установки PAIR ищет узлы через mDNS или по заданному IP-адресу. Первичное объединение подтверждается шестизначным PIN-кодом, после чего узлы обмениваются сертификатами. Каналы внутри кластера защищаются взаимной TLS-аутентификацией.
Планировщик учитывает готовность узла, состояние движка, наличие требуемой модели, число активных задач и грубый показатель загрузки GPU. Затем весь запрос передаётся одному выбранному компьютеру. Ответ возвращается приложению через тот же локальный endpoint.
Практически это означает такую цепочку:
- приложение или агент обращается к PAIR на том же компьютере;
- PAIR проверяет, где есть нужная модель и готовый движок;
- один узел целиком выполняет запрос;
- несколько независимых запросов могут параллельно уйти на разные узлы.
Локальная точка доступа намеренно принимает соединения только с loopback-интерфейса. PAIR нужно устанавливать на машине, где работает приложение. Если компании требуется общий сетевой API для множества рабочих мест, его публикация, аутентификация пользователей, лимиты и аудит находятся за пределами проекта и требуют отдельного шлюза.
Чего PAIR принципиально не делает
Главное ограничение сформулировано в документации прямо: PAIR не объединяет видеопамять, не складывает вычислительные мощности нескольких GPU для одного задания, не делит модель на части и не распределяет один запрос между узлами.
Если модель требует 24 ГБ памяти, а на каждом из трёх компьютеров доступно только 12 ГБ, кластер не создаст виртуальные 36 ГБ. Модель должна целиком помещаться и запускаться хотя бы на одном узле. То же относится к большому контексту: если конкретная комбинация модели, квантования и длины запроса не помещается на выбранной машине, наличие других узлов это не исправит.
PAIR полезен там, где узкое место — очередь независимых задач:
- несколько сотрудников одновременно обращаются к одному локальному помощнику;
- агент запускает независимые подзадачи исследования или классификации;
- нужно обработать пачку документов, обращений или карточек товаров;
- разработчики делят ограниченный парк машин для тестов;
- одна модель уже установлена на нескольких узлах и может обслуживать больше параллельных запросов.
Он не решает задачу запуска одной слишком большой модели и не заменяет специализированный распределённый inference-сервер с шардированием весов.
Почему смешанный парк надо тестировать особенно внимательно
Текущий планировщик PAIR остаётся сравнительно простым. Архитектурная документация предупреждает: при выборе узла он не учитывает модель GPU, объём свободной VRAM, измеренную задержку и ожидаемую стоимость конкретного запроса. Короткая классификация и длинная генерация отчёта для счётчика выглядят как по одной активной работе.
В однородном парке это терпимо. В смешанном кластере быстрый и медленный компьютеры могут получать задания без достаточной поправки на их реальную производительность. В результате средняя пропускная способность вырастет, а хвостовая задержка отдельных запросов — ухудшится.
Документация также перечисляет ограничения бета-версии: показатели общей памяти GPU иногда определяются неточно, зависший сервис не всегда обнаруживается автоматически, а терминальный интерфейс не даёт полного управления моделями и удалёнными движками. На macOS возможны особенности доступности узла после выхода из кластера. Это нормальные для раннего релиза оговорки, но в производственном расчёте их нельзя заменять обещанием «кластер сам всё сбалансирует».
Безопасность: локально не означает автоматически изолированно
PAIR проектировался для доверенной локальной сети. Шестизначный PIN защищает только начальное подключение и имеет низкую энтропию; постоянным секретом он не является. После объединения mTLS защищает каналы кластера, но не весь окружающий контур.
В область mTLS не входят, например, метаданные обнаружения, локальный HTTP-интерфейс приложения и сторонние API самих inference-движков. Кроме того, локальный маршрут запроса не доказывает, что весь стек никогда не обращается наружу: приложение, каталог моделей, установщик, обновления или сам движок могут использовать интернет.
Для рабочего контура разумны минимальные меры:
- выделить узлы в управляемый сегмент сети и ограничить межсетевые правила;
- подключать только инвентаризированные машины и проверять PIN по отдельному каналу;
- запускать движки с минимальными правами и фиксировать версии;
- проверить исходящие соединения приложения, движка и механизмов обновления;
- не публиковать loopback endpoint в сеть без отдельной аутентификации и аудита;
- использовать обезличенный тестовый набор до допуска реальных документов.
Если данные относятся к коммерческой тайне или регулируемым категориям, решение о контуре должно опираться на модель угроз и правила компании, а не только на слово «local» в названии.
Экономика: считать принятую работу, а не число подключённых GPU
NVIDIA показывает демонстрацию, где пять агентных подзадач на трёх устройствах заняли 8 минут 48 секунд против 18 минут на одном ноутбуке. Это полезная иллюстрация параллелизма, но результат получен разработчиком на конкретной конфигурации и не является независимым прогнозом для чужого парка.
Для малого бизнеса ценность PAIR появляется, если подходящие компьютеры уже куплены, простаивают часть дня и получают несколько одновременных заданий. Тогда пилот почти не требует капитальных затрат. Но «бесплатная мощность» всё равно включает электричество, администрирование, простои рабочих станций и проверку результатов человеком.
Модельный расчёт можно вести по формуле:
`стоимость принятого результата = (электроэнергия + поддержка + доля амортизации + проверка человеком) / число принятых результатов`.
Сравнивать нужно не токены и не пиковые запросы в секунду, а принятые документы, ответы или классификации за час. Отдельно фиксируются медиана и p95 полной задержки, время в очереди, доля ошибок, холодный и прогретый запуск, энергопотребление и влияние на владельца рабочей станции.
Если параллельного спроса почти нет, PAIR добавит ещё один сервис и почти не даст эффекта. Если спрос стабилен и критичен, отдельный inference-сервер может оказаться проще в эксплуатации, чем парк разнородных пользовательских машин.
Пилот на одну-две недели
Безопасный первый эксперимент помещается в небольшой контур из двух-трёх существующих узлов. Нужны одна-две подходящие модели, одинаковая версия движка там, где это возможно, и набор из 100–300 обезличенных реальных запросов.
Полезно сравнить три сценария:
1. Один узел без PAIR — базовая линия.
2. Два-три узла с одинаковой моделью — проверка параллельной очереди.
3. Смешанный парк и разные модели — проверка правил отбора и хвостовой задержки.
Пилот лучше проводить в теневом режиме: агент формирует ответ, но не меняет CRM, учётную систему или документы без подтверждения человека. Кроме производительности следует проверить отключение узла, зависание движка, повтор запроса, журналирование и процедуру удаления машины из кластера.
Критерий решения задаётся заранее: например, не менее заданного числа принятых результатов в час при p95 ниже бизнес-порога и без роста ручной проверки. Откат прост — вернуть приложение на исходный endpoint, вывести узлы из кластера и удалить PAIR. Данные и модели при этом остаются в существующих движках.
Что взять руководителю
PAIR стоит проверять, когда в компании уже есть несколько совместимых машин и реальные параллельные задачи: пакетная обработка, несколько пользователей или агентные подзадачи. Сначала инвентаризируйте узлы, выберите один измеримый процесс и проведите теневой прогон.
Если цель — запустить одну модель, которая не помещается ни на одном компьютере, этот инструмент не подходит. Такое различие экономит больше времени, чем любой впечатляющий график загрузки: маршрутизатор сокращает очередь, но не отменяет физические границы каждого узла.