Что опубликовано
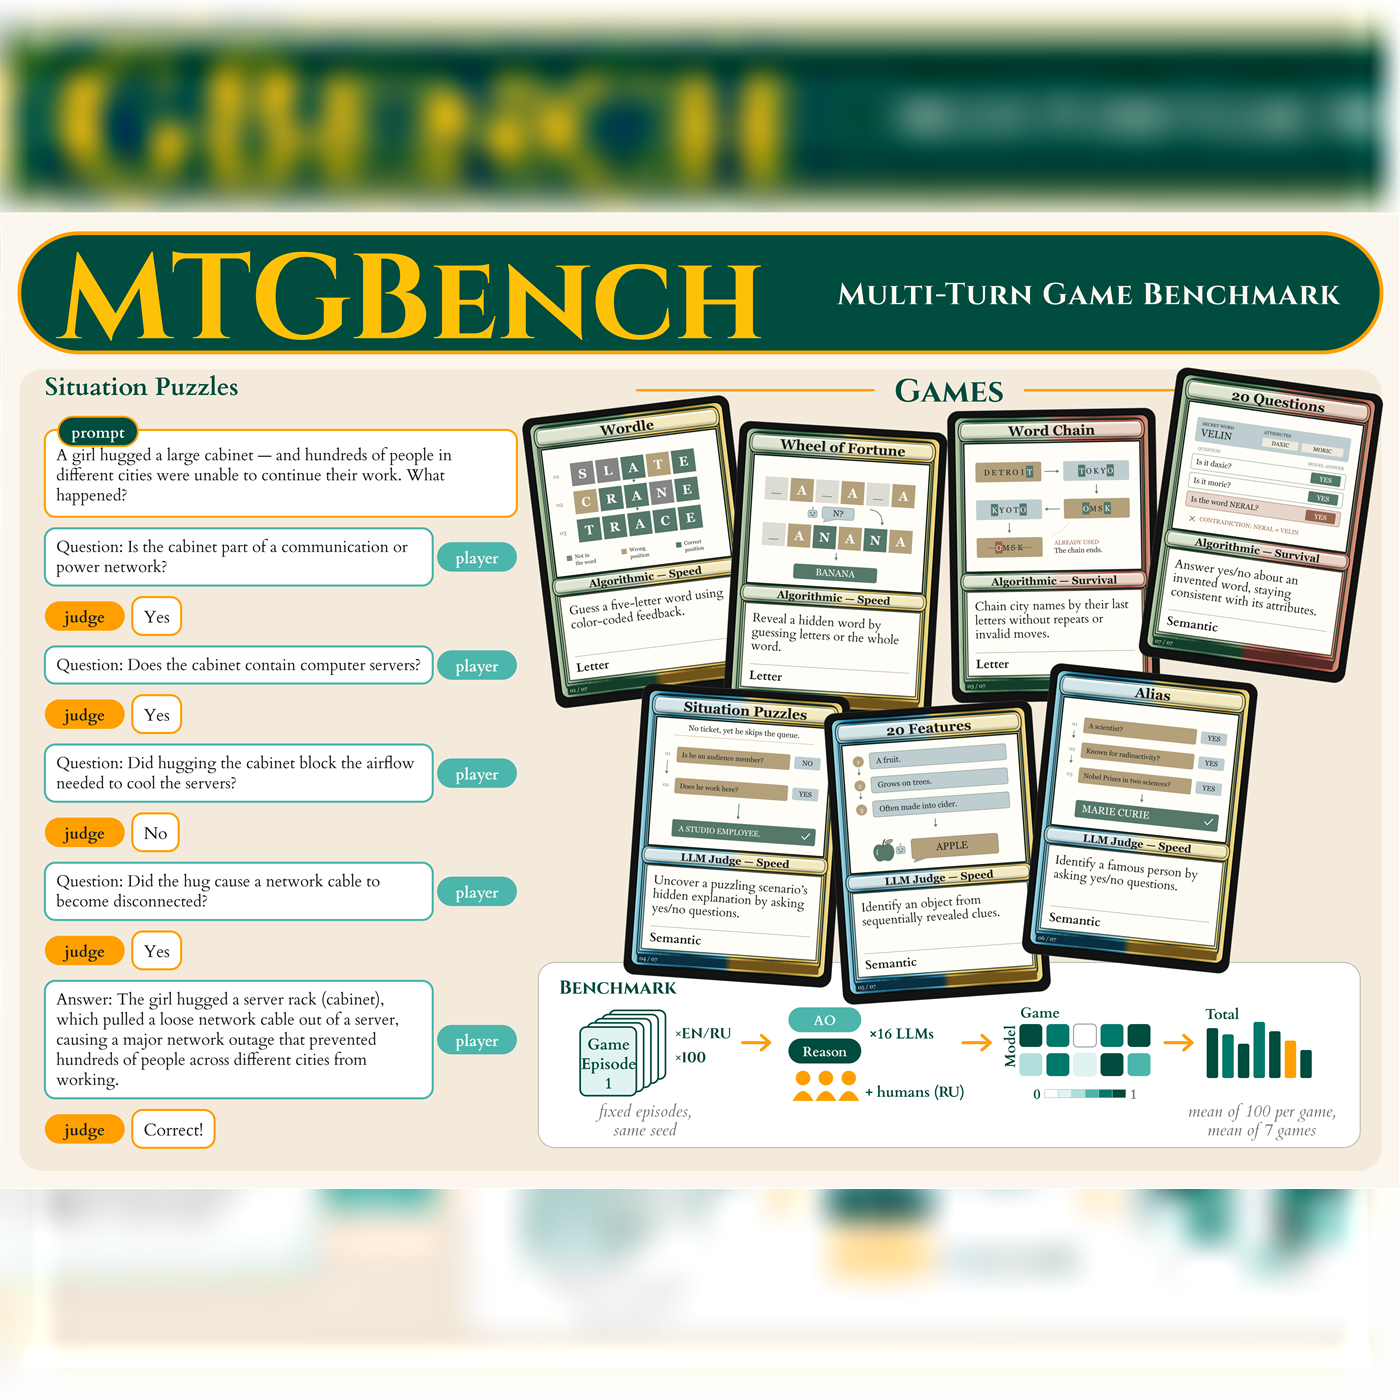
27 октября Яндекс и Школа анализа данных (ШАД) выпустили MTGBench — открытый бенчмарк для проверки того, как языковая модель ведёт себя в длинном диалоге. В наборе семь текстовых игр: Wordle, «Поле чудес», «Города», «Данетки», «20 вопросов», «20 признаков» и «Элиас». Следующий ход зависит от предыдущих: модель должна учитывать новые сведения, планировать шаги и не противоречить собственным ответам.
Задания подготовлены отдельно на русском и английском языках. В четырёх играх ответы проверяет алгоритм, в трёх — ИИ-судья, качество которого сверяли с человеческими оценками. Авторы протестировали 16 моделей. Статья о работе опубликована в Findings of EMNLP 2026; код и материалы доступны в репозитории проекта.
Что показали авторы
Режим пошаговых рассуждений помогал не одинаково во всех задачах. Наиболее заметная польза была в играх с буквами и символами, разбором подсказок и исключением неверных вариантов. В заданиях на поиск знаний и понимание смысла выигрыш был менее стабильным и зависел от конкретной модели. Результаты также различались между играми, а на русском языке модели в среднем справлялись хуже, чем на английском.
Для бизнеса это не готовый рейтинг моделей. Скорее, MTGBench наглядно показывает, почему единый балл или короткий тест не предсказывает качество помощника в диалоге: результат меняется вместе с задачей, языком, длиной контекста и способом оценки.
Как применить вывод
Для пилота в поддержке, продажах или внутренней базе знаний полезно заимствовать сам принцип проверки, а не игровые задания. Соберите небольшой набор обезличенных многошаговых диалогов из своего процесса и проверьте, умеет ли модель:
- удерживать факты из предыдущих сообщений;
- учитывать уточнения и новые ограничения;
- задавать следующий полезный вопрос;
- не выдавать взаимоисключающие ответы;
- доводить сценарий до нужного результата при приемлемых задержке и стоимости.
Сравнивайте модели на одинаковых сценариях, отдельно на русском языке и с одинаковыми настройками. Важное ограничение: головоломки MTGBench не заменяют оценку поиска по корпоративным данным, соблюдения регламента или качества ответа клиенту. Для повторения эксперимента также потребуется настроить окружение и проверить условия сторонних словарных ресурсов из репозитория.
Практический итог — добавьте к обычной проверке точности несколько диалогов с изменением вводных. Это недорогой способ заметить потерю контекста до того, как помощник попадёт в рабочий процесс.