Задача: не отправлять лишнее в ИИ
Компания хочет искать ответы в договорах, письмах поддержки и внутренних инструкциях. Технически подключить документы к RAG нетрудно. Сложнее решить, какие сведения вообще должны попасть в индекс, промпт модели, журнал запросов и резервную копию. В одном письме могут соседствовать полезное описание проблемы, имя клиента, телефон, номер заказа и банковские реквизиты. Если индексировать всё подряд, поисковый слой начинает тиражировать избыточные данные.
Локальный контур снижает риск передачи данных внешнему провайдеру, но сам по себе не отменяет разграничение доступа и минимизацию данных. Сотрудник с широкими правами, ошибочная выдача поискового индекса или слишком подробная телеметрия способны раскрыть сведения и внутри компании. Поэтому перед пилотом RAG нужен отдельный вопрос: какие поля необходимы для ответа, а какие следует обнаружить, удалить либо заменить устойчивым псевдонимом ещё до индексации?
Что подтверждено в Presidio
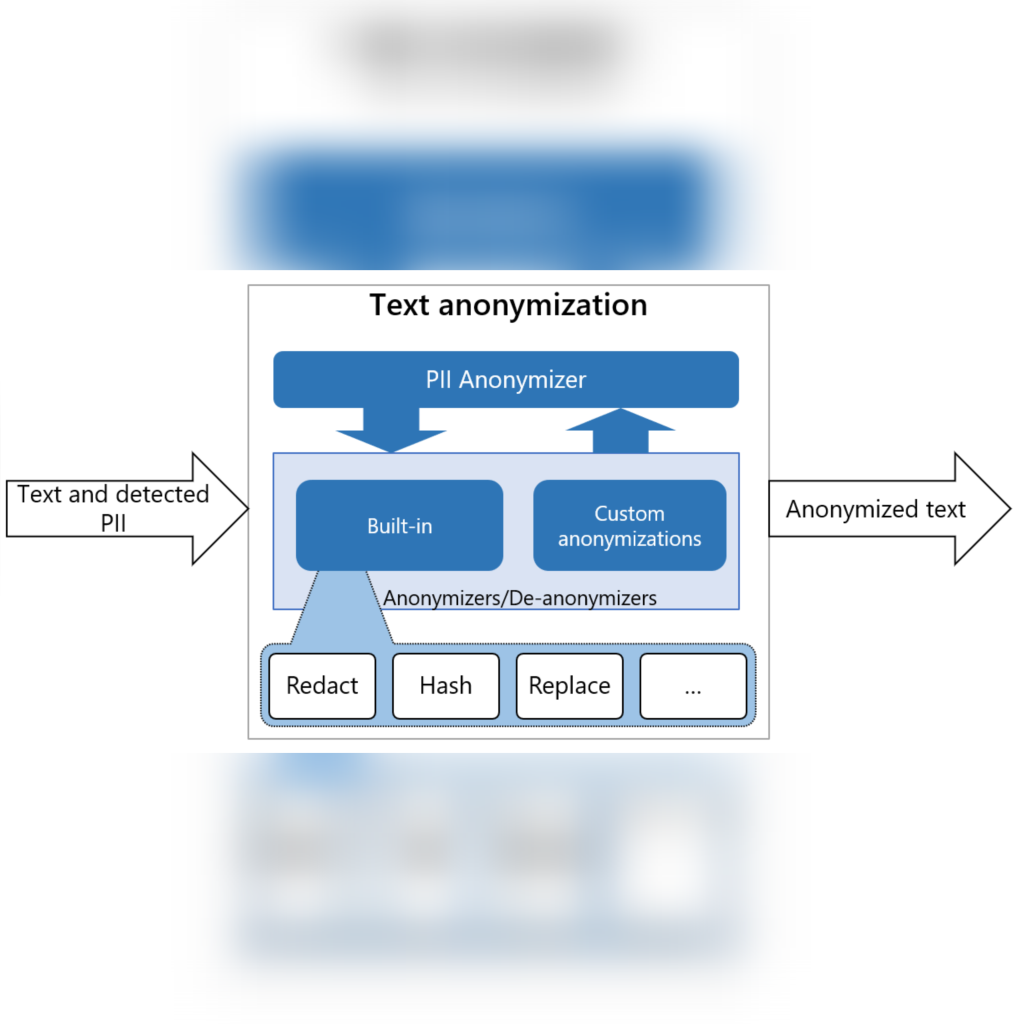
Открытый проект Presidio содержит Analyzer для поиска чувствительных сущностей и Anonymizer для их преобразования. В распознавании сочетаются регулярные выражения, контрольные суммы, контекстные признаки, готовые и собственные модели. Преобразования включают замену, маскирование, удаление и хеширование. Есть инструменты для изображений и структурированных данных. Код и документация опубликованы по MIT-лицензии. Это библиотека и набор компонентов, а не готовая гарантия соответствия требованиям защиты данных.
Важное ограничение указано самими разработчиками: автоматическое обнаружение не находит все чувствительные сведения. Конфигурация по умолчанию ориентирована на английский язык; документация описывает подключение других языков и собственных распознавателей. Для русских договоров нельзя считать установку пакета достаточной проверкой. Нужны подходящая языковая модель, правила для местных форматов и тестовый набор именно ваших документов. Названия компаний, должности, номера договоров и внутренние коды часто требуют отдельных правил.
На официальной схеме Presidio показан только один этап — преобразование уже найденных сущностей. Это полезное напоминание: качество маскирования не исправит пропуск детектора. Если распознаватель не заметил номер счёта или фамилию, Anonymizer оставит исходный фрагмент на месте.
Где поставить контроль в архитектуре
Практичная цепочка для небольшого бизнеса выглядит так: источник документов → выделение текста и метаданных → классификация доступа → обнаружение чувствительных фрагментов → решение о преобразовании → индекс RAG → извлечение с проверкой прав → ответ с цитатой. Параллельно нужно ограничить то, что попадает в логи и резервные копии. Это не универсальная схема для всех юридических режимов, а инженерный порядок проверки.
Для каждой коллекции заранее определите цель. Например, для поиска ответов на типовые вопросы поддержки может быть достаточно описания неисправности, модели изделия и итогового решения. Имя и телефон клиента в поисковом индексе могут не понадобиться. Напротив, если сотруднику нужно открыть конкретный заказ, безопаснее хранить ссылку на запись в CRM и получать детали из неё по текущим правам доступа, чем размножать карточку клиента по векторному индексу.
Отдельно различайте три операции:
- Удаление — исходное значение больше не нужно для задачи и не должно восстанавливаться из индекса.
- Маска или метка вроде `CLIENT_17` — связь между упоминаниями нужна внутри одного документа или диалога, но настоящая личность в поиске не нужна.
- Обратимое преобразование — восстановление действительно требуется в конкретном рабочем процессе; ключ и таблица соответствий тогда остаются в отдельном защищённом хранилище, а не рядом с индексом.
Простой хеш не равен анонимности: короткие и предсказуемые значения можно перебирать, а одинаковый результат позволяет связывать записи. Документация Presidio прямо описывает соль для хеширования и отдельно предупреждает, что стабильный результат между вызовами требует управляемой соли. Если связность не нужна, не создавайте её ради удобства разработки.
Какие данные и интеграции понадобятся
Для пилота не нужен весь архив. Достаточно одного процесса и небольшой репрезентативной выборки: письма разных типов, сканы разного качества, вложения, таблицы и документы с исключениями. Выборку нужно размечать вручную в защищённом контуре: какие фрагменты чувствительны, какой класс у каждого фрагмента и что допустимо показывать каждой роли. Само тестовое хранилище содержит исходные данные и потому требует контроля доступа и срока хранения.
Затем настройте распознаватели под предметную область. Для электронных адресов и телефонов полезны шаблоны, но для имени клиента или произвольного адреса потребуется языковая модель и контекст. Для внутренних идентификаторов пригодятся словари и собственные правила. Сканы сначала проходят OCR, причём ошибка OCR может разрушить шаблон номера: детектор не может найти то, что извлекатель текста потерял. Сохраняйте связь между извлечённым фрагментом и страницей исходника, чтобы проверяющий мог разобраться в ошибке.
Интеграция с RAG должна проверять права не только при загрузке, но и при выдаче. Маскирование не заменяет ACL. Индекс с обезличенным текстом может содержать коммерческие условия, зарплаты или сведения о проекте, которые доступны не всем. Поэтому метаданные о владельце документа, версии, разрешённых ролях и сроке актуальности должны переживать извлечение текста и попадать в фильтр поиска. Запрос пользователя не должен становиться основанием расширить эти права.
Для локального запуска нужны сервер или рабочая станция для OCR, распознавания и индекса, хранилище документов, служебная БД для метаданных и резервное копирование. Объём памяти и необходимость GPU зависят от выбранной языковой модели и потока документов; Presidio не диктует одну аппаратную конфигурацию. На малом объёме разумно начать с CPU и измерить задержку, затем решать вопрос ускорителя по фактической нагрузке. Тяжёлый OCR и обработку больших архивов лучше вынести из интерактивного запроса в фоновую очередь.
Как измерить качество, а не только число найденных имён
На размеченной выборке считайте минимум два типа ошибок. Пропуск чувствительного фрагмента — риск утечки. Ложное срабатывание — потеря полезного контекста: модель может не понять, о каком товаре или договоре идёт речь. Для каждого класса данных оцените полноту и точность отдельно, а не одним общим процентом. Редкие, но критичные классы — реквизиты, паспортные данные, медицинские сведения — нельзя «спрятать» в хорошем среднем результате по частым адресам электронной почты.
Проверьте весь маршрут, а не один детектор. Сделайте контрольные запросы к RAG от ролей с разными правами, посмотрите извлечённые фрагменты, итоговые ответы, логи приложения, трассировки, кэш и экспорт. Если исходный текст не дошёл до индекса, но попал в журнал ошибки, риск не устранён. Если после маскирования ответ всё равно позволяет узнать человека из сочетания оставшихся деталей, требуется пересмотреть набор полей и правила доступа.
Экономика и следующий шаг
Главные статьи затрат — разметка эталонной выборки, настройка русских и отраслевых распознавателей, ручная проверка исключений и сопровождение правил при изменении форм документов. Само программное обеспечение открыто, но это не делает проект бесплатным. Не обещайте экономию до измерения доли документов, которые можно пропускать автоматически без неприемлемого риска.
Начните с одного корпуса — например, закрытых обращений поддержки за месяц. Зафиксируйте цель поиска и роли пользователей, разметьте выборку, сравните выдачу до и после маскирования, а спорные документы отправляйте на ручную проверку. Критерий пилота прост: нужный ответ остаётся доступен уполномоченному сотруднику, а лишние персональные и конфиденциальные сведения не появляются в индексе, ответе и логах. Если этого нет, расширять RAG на весь архив рано.
Источники: документация и репозиторий Presidio; конфигурация языка и руководство по расширению распознавателей; NIST SP 800-122 — общая модель оценки риска идентифицирующих сведений. Выводы об архитектуре и пилоте — редакционный анализ, а не заявленный результат внедрения конкретной компании.