Кейс: царапина одна, источников данных четыре
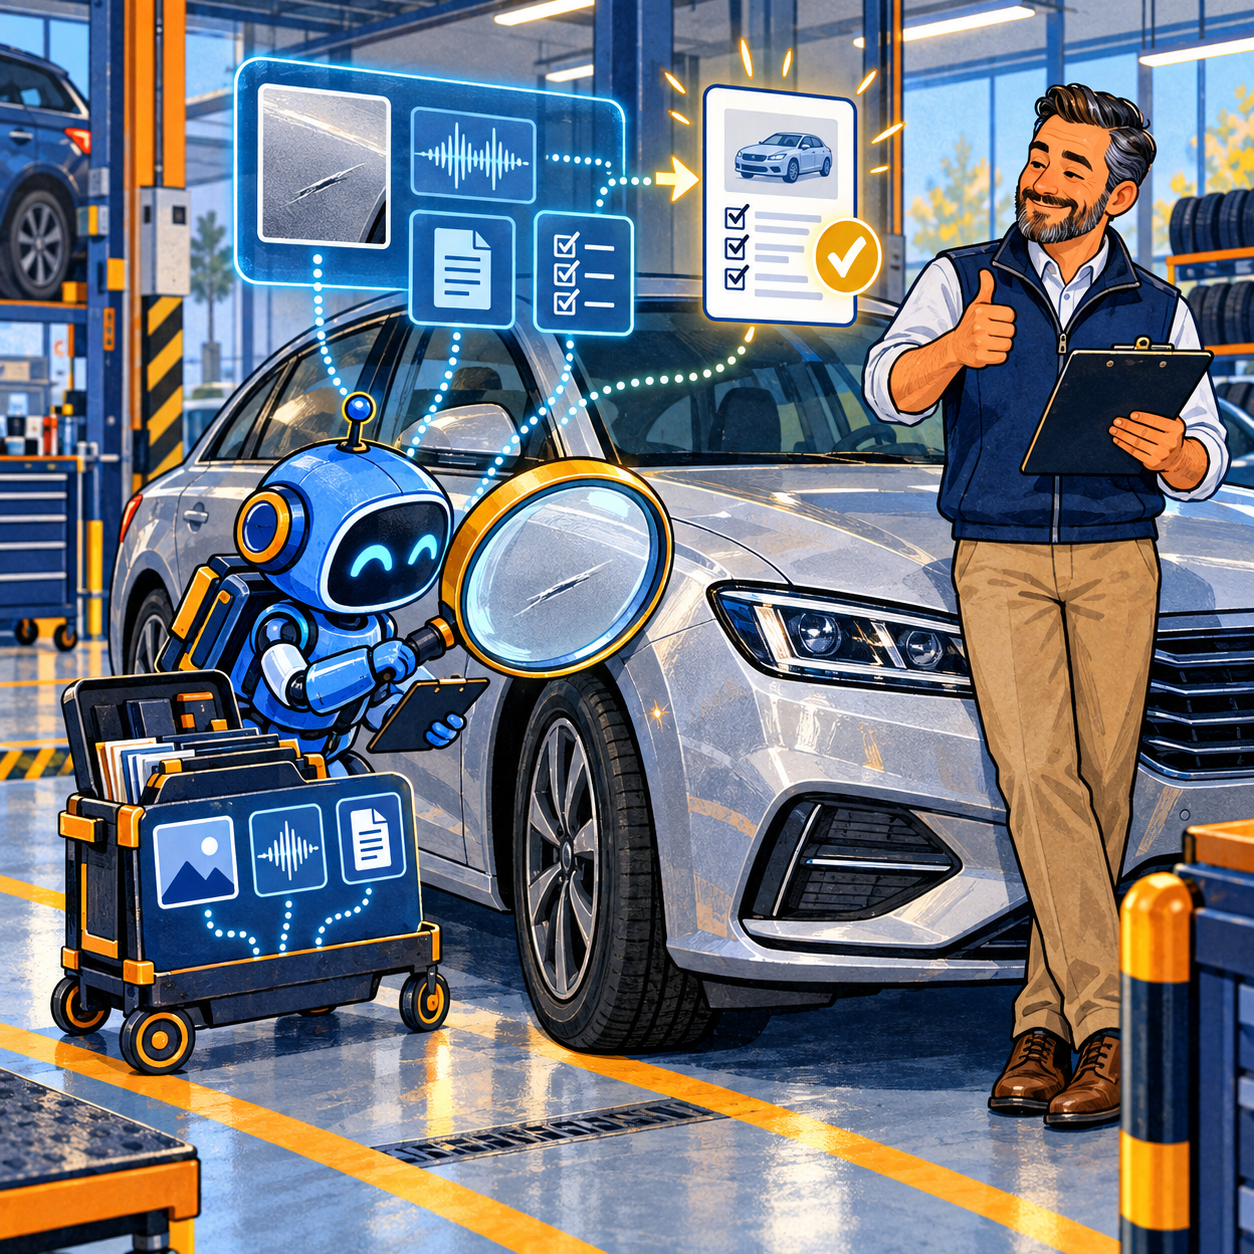
Сербская компания TUBEIQ, разработчик low-code-систем для автоматизации процессов, вместе с DunavNET и прокатчиком AAA-1 RENT собрала платформу Damage Control. Она помогает готовить отчёт о повреждениях автомобиля из фотографий, голосового описания, документов и истории осмотров.
Проблема выглядит скромно, пока не посчитать ручные действия. Сотруднику нужно снять автомобиль, прослушать комментарий, сверить прежние материалы, определить тип и место повреждения, а затем оформить единый отчёт для проката или страховщика. Если каждый источник живёт отдельно, маленькая царапина быстро обзаводится биографией в трёх томах.
В проекте компьютерное зрение, распознавание речи, OCR и генеративная модель объединены в один конвейер. Результат — структурированный машиночитаемый отчёт, который можно передать в систему проката, управления автопарком или урегулирования убытков.
Что в проекте подтверждено
FFplus сообщает, что команда использовала суперкомпьютер LUMI для обучения, дообучения и параллельного сравнения открытых моделей. На эксперименты ушло 6 162 GPU-node-часа. Параллельная проверка вариантов сократила цикл разработки с недель до дней и помогла выбрать более точный подход.
AAA-1 RENT предоставила предметную экспертизу, требования и проверку на реальном процессе. В материалах проекта говорится о высокой точности обнаружения и описания повреждений, но числовой метрики, состава тестовой выборки и порогов ошибок не опубликовано. Поэтому корректный вывод — работоспособность конвейера подтверждена, а перенос заявленного качества на другой автопарк ещё нужно проверять.
Проценты в разделе выгод — сокращение времени подготовки отчёта на 30–40%, расходов на осмотр на 20–25% и споров до 30% — обозначены проектом как прогнозируемый эффект. Аналогично, выход на рынок через 3–6 месяцев и выручка свыше €500 тыс. за три года относятся к плану, а не к уже полученному финансовому результату.
Почему здесь важен конвейер, а не одна «умная модель»
Для похожего проекта не требуется искать единственную модель, которая одновременно видит вмятину, понимает речь, читает акт и знает правила компании. Надёжнее разделить процесс на контролируемые этапы:
- приложение фиксирует фотографии по обязательным ракурсам, VIN или внутренний номер, дату, сотрудника и условия съёмки;
- модуль зрения находит кандидатные зоны и сравнивает их с предыдущим осмотром;
- распознавание речи превращает комментарий инспектора в текст;
- OCR извлекает поля из акта, счёта или страхового документа;
- слой правил проверяет обязательные поля, допустимые значения и противоречия;
- генеративная модель собирает объяснение и черновик отчёта, но не переписывает исходные доказательства;
- человек подтверждает критичные выводы, после чего интеграционный слой отправляет результат в учётную систему.
Главный артефакт — не красивый абзац, а JSON с идентификаторами фотографий, координатами дефекта, версией модели, уверенностью, извлечёнными полями и решением проверяющего. Текстовый отчёт строится поверх него. Тогда при споре можно восстановить, почему система решила, что бампер получил новую царапину, а не просто встретился с особенно артистичной тенью.
Какие данные понадобятся
Минимальный набор для пилота — пары «до/после», разметка типа, места и серьёзности повреждения, образцы голосовых комментариев, формы документов и итоговое решение опытного инспектора. Данные стоит разделять по автомобилям, а не случайным фотографиям: снимки одной машины в обучении и тесте создадут слишком оптимистичную оценку.
Нужно заранее описать сложные случаи: грязь, дождь, блики, ночь, разные телефоны, уже существующий дефект, заменённая деталь, плохой звук и неполный комплект снимков. Отдельный тестовый набор должен оставаться неизменным между версиями модели.
Фотографии автомобиля, голос, номера документов и сведения о клиенте могут содержать персональные или коммерчески чувствительные данные. Для российского внедрения потребуется собственная правовая и ИБ-проверка: минимизация состава данных, сроки хранения, разграничение доступа, журналирование выгрузок и удаление по регламенту. Локальный контур полезен, но сам по себе не превращает беспорядочную папку с фото в безопасную систему.
Инфраструктура: суперкомпьютер нужен не навсегда
В кейсе LUMI использовался как исследовательский ускоритель: много вариантов моделей обучались и сравнивались параллельно. Это не означает, что каждому пункту проката нужен суперкомпьютер рядом с мойкой. После выбора моделей продуктивный контур можно разделить:
- лёгкая предварительная проверка качества снимка — на рабочей станции или мобильном устройстве;
- зрение, OCR и речь — на одном сервере с GPU либо в частном облаке;
- генерация отчёта — локальной языковой моделью подходящего размера;
- хранение оригиналов и версий результатов — в объектном хранилище с неизменяемыми идентификаторами;
- интеграция — через очередь задач и API, чтобы сбой одного модуля не терял весь осмотр.
Требования к памяти и производительности в материалах кейса не раскрыты. Их нельзя вывести из 6 162 GPU-node-часов: это расход на разработку, а не спецификация промышленного сервера. Для закупки оборудования нужен отдельный тест на собственных снимках, требуемой задержке и дневном пике осмотров.
Экономика пилота: сначала минуты, потом обещания
Ниже — модельный расчёт, а не результат TUBEIQ. Допустим, компания проводит 1 000 осмотров в месяц. Ручной отчёт занимает 15 минут, а после внедрения сотрудник тратит 7 минут на проверку и исправление черновика. Экономия составляет около 133 часов в месяц.
При полной стоимости рабочего часа 900 ₽ это 120 тыс. ₽ валового эффекта. Если сервер, хранение, поддержка и контроль качества стоят 70 тыс. ₽ в месяц, остаётся около 50 тыс. ₽. Интеграция за 600 тыс. ₽ при таких допущениях окупится примерно за год. Если модель часто ошибается и проверка занимает 12 минут, эффект почти исчезнет — робот всё ещё трудится, но бухгалтерия уже не аплодирует.
Считать нужно не число распознанных фотографий, а стоимость принятого отчёта:
- долю осмотров, прошедших без повторной съёмки;
- медианное время до подтверждения;
- долю ручных исправлений по полям;
- пропущенные новые дефекты и ложные срабатывания;
- число споров и время их разрешения;
- стоимость инфраструктуры и поддержки на один подтверждённый отчёт.
Как начать без большого эксперимента
Для пилота достаточно одного пункта выдачи, одного класса автомобилей и 200–500 осмотров в теневом режиме. Система готовит отчёт, но решение пока принимает сотрудник по обычному процессу. Через четыре недели сравнивают скорость, ошибки и расхождения.
До старта зафиксируйте допустимые пороги для пропуска дефекта и ложной тревоги, обязательные ракурсы, правила повторной съёмки и перечень действий, которые ИИ не выполняет самостоятельно. В продуктивный режим стоит переводить только те типы повреждений, где качество стабильно на собственных данных.
Что взять руководителю
Ценность мультимодального ИИ появляется не от ещё одной модели, а от связки доказательств, правил, интеграции и человеческого подтверждения. Начните с одного измеримого этапа — подготовки черновика отчёта — и не включайте автоматическое решение по спорным случаям, пока метрики не выдержат реальный свет, грязь и понедельник утром.