Почему фильтры нужно продумать заранее
В корпоративном поиске похожесть текста — не единственное условие. Сотрудник может видеть документы только своего филиала, действующие инструкции, определённый продукт или документы нужного подразделения. Такие ограничения обычно лежат в метаданных документа: tenant, филиал, тип, статус, дата действия, владелец.
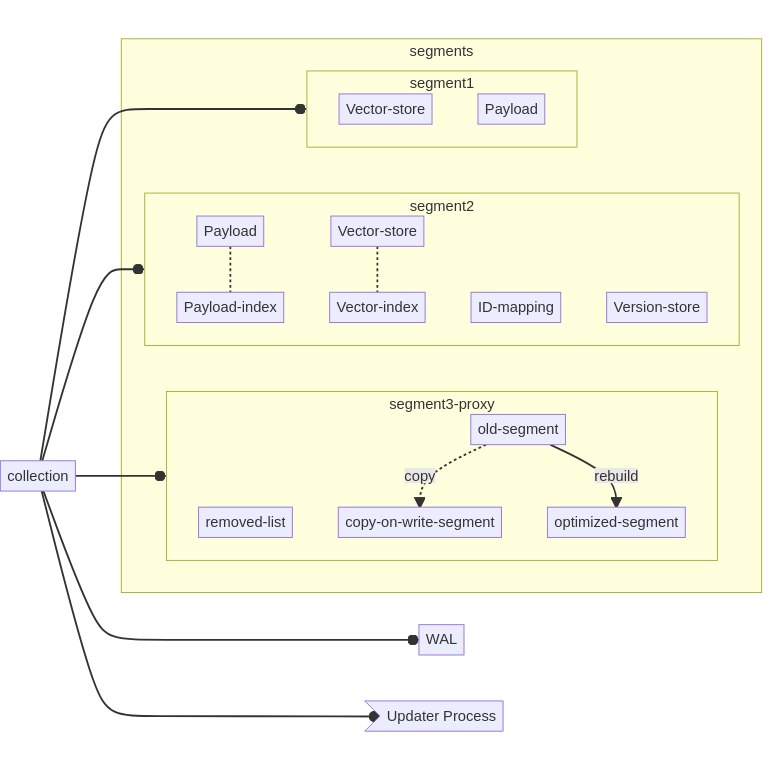
В Qdrant фильтр работает по payload — структурированным полям, хранящимся рядом с вектором. Если поле часто участвует в фильтрации, для него можно создать payload-индекс. Документация Qdrant рекомендует создать такие индексы до загрузки данных: тогда при построении HNSW могут добавиться рёбра, которые помогают поиску с фильтрами. Если индекс создаётся после загрузки, фильтр продолжит работать, но чтобы использовать filter-aware edges, потребуется перестройка HNSW.
Сначала вопросы, потом схема индекса
Не нужно индексировать каждое поле «на всякий случай». Дополнительный индекс требует вычислительных ресурсов и памяти. Выбирать поля стоит по реальным запросам пользователей и логике доступа.
Для небольшой команды полезно пройти короткий инвентаризационный цикл:
- собрать 10–20 вопросов, которые сотрудники действительно задают внутренней базе;
- выписать поля, которыми ограничивается поиск: филиал, вид документа, статус или период;
- определить, кто и в каком источнике поддерживает каждое значение;
- проверить, что значения нормализованы и не дублируются под разными написаниями;
- создать только индексы для полей, которые нужны фильтрам или политике доступа.
Если документы разных организаций или подразделений находятся в одной коллекции, tenant или филиал — не просто удобство для поиска. Это часть границы доступа. Нельзя полагаться только на prompt модели: фильтр должен применяться на стороне retrieval, а права пользователя — проверяться сервисом, который формирует запрос к векторному хранилищу.
Что проверять в прототипе
Создайте небольшую тестовую коллекцию и сравните запросы с фильтром и без него. Измеряйте не только среднюю задержку, но и p95 на типичных и «узких» фильтрах. Проверьте, что поиск не возвращает документы соседнего филиала, архивные инструкции или материалы без нужного статуса. Затем оцените размер payload-индексов и нагрузку на обновление.
Qdrant отмечает, что для отфильтрованного поиска дополнительные HNSW-рёбра добавляются для каждого индексированного поля по отдельности, а не для каждой комбинации полей. Поэтому сочетание нескольких строгих фильтров всё равно может потребовать отдельной проверки релевантности и задержки. Комбинации могут дать другой результат, чем каждый фильтр отдельно.
Если коллекция уже заполнена
Поздний payload-индекс не обязывает загружать документы заново, но для filter-aware HNSW нужно перестроить граф. Такая операция ресурсоёмкая и может занять время на большой коллекции. До перестройки проверьте объём, план обслуживания, дисковое пространство и возможность безопасно перенести нагрузку. На небольшом прототипе это простой эксперимент; на рабочей базе — изменение, которое нужно планировать.
Экономика и границы применимости
Избыточные индексы увеличивают память и стоимость обслуживания; недостаточные могут ухудшить время поиска или помешать эффективной фильтрации. Не существует универсального списка полей для всех баз знаний. Профиль обращений бухгалтерии, поддержки и отдела продаж будет различаться, как и требования к доступу.
Начните с десяти реальных вопросов и таблицы «поле — зачем нужен фильтр — кто заполняет — кто имеет право видеть». После этого создайте коллекцию с минимальным набором индексов, проверьте качество и p95, а уже затем переносите объём. Такой порядок дешевле, чем перестраивать большой граф после обнаружения, что важное поле забыли.