Почему лимит в конфигурации ещё не означает контроль расходов
Когда в компании появляется второй AI-сервис, общий ключ к модели быстро превращается в непрозрачную кассу. Нельзя уверенно ответить, кто создал нагрузку, какой процесс расходует токены и сработает ли ограничение во время всплеска параллельных запросов. Поэтому между приложениями и моделями часто ставят LLM-шлюз: он выдаёт виртуальные ключи, маршрутизирует запросы, считает потребление и применяет лимиты.
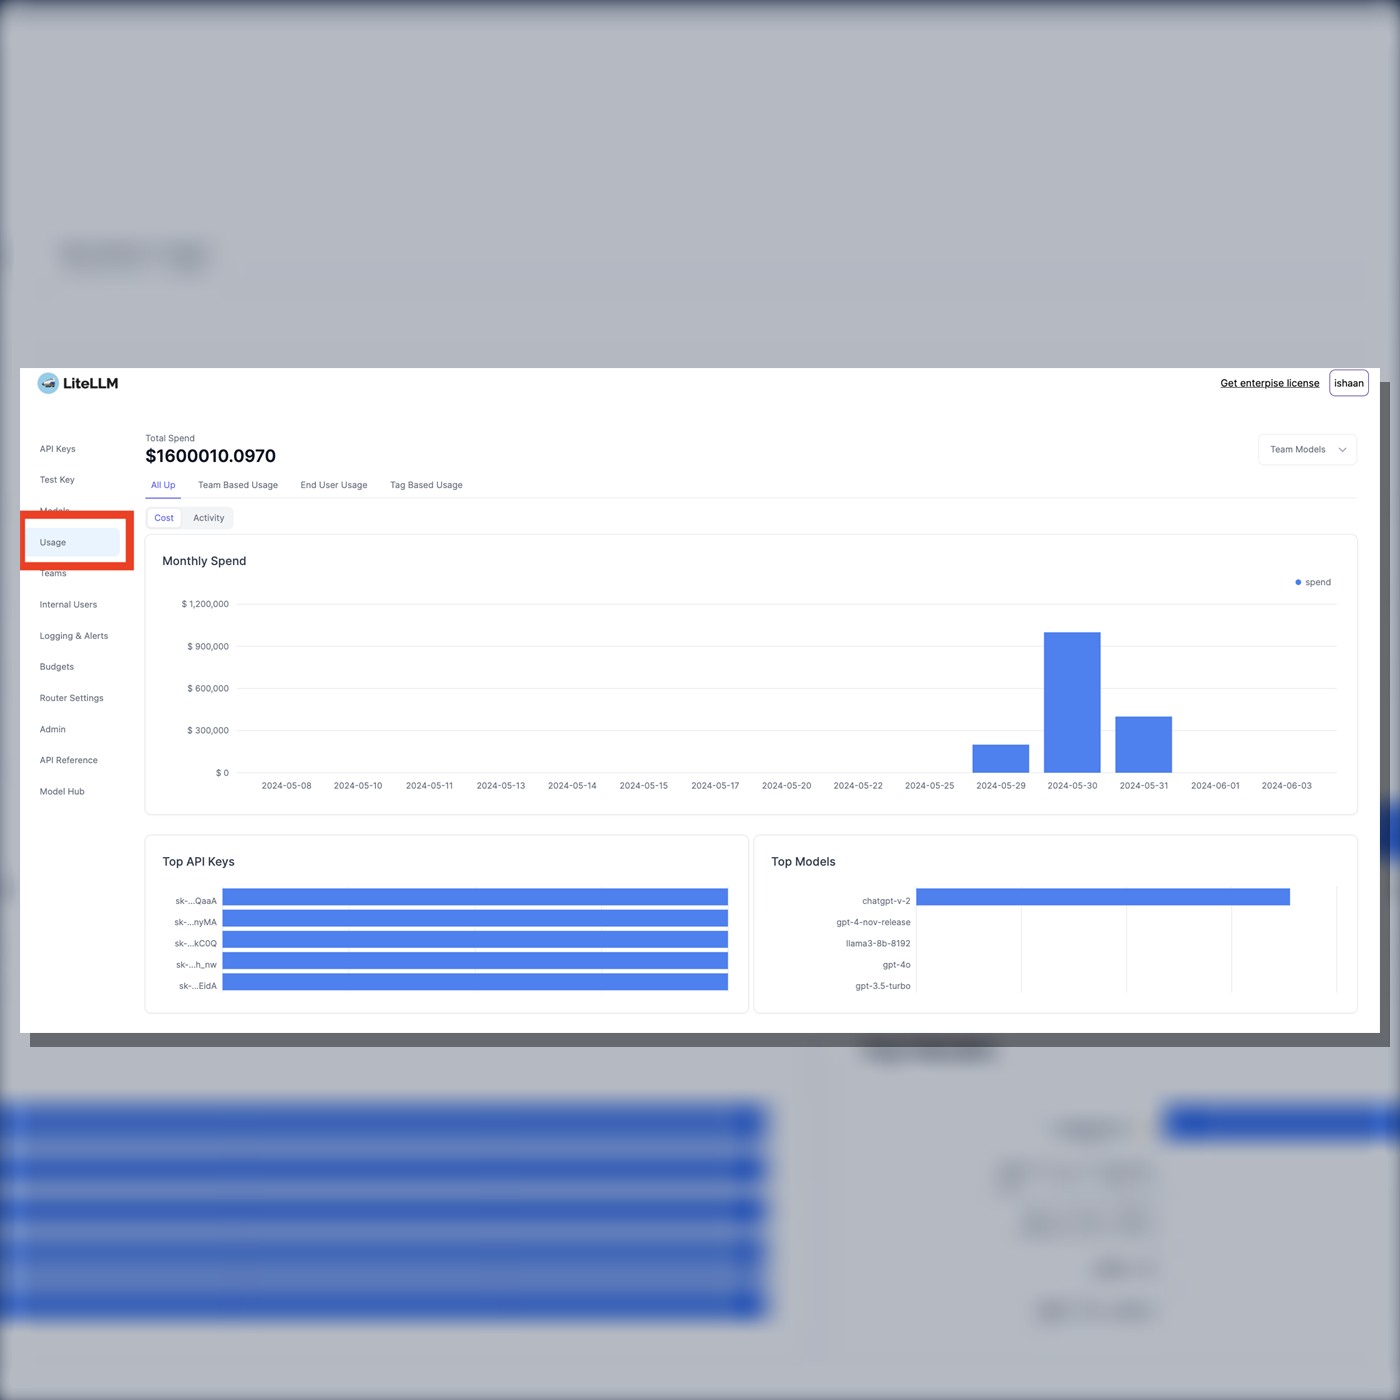
На примере LiteLLM хорошо видно важное архитектурное ограничение: поле бюджета само по себе не является финансовым предохранителем. Официальная документация прямо предупреждает, что бюджеты требуют базы данных. В развёртывании без БД глобальный лимит не получает накопленную сумму для сравнения и пропускает запросы дальше; бюджеты ключей, команд и пользователей также недоступны.
Для малого и среднего бизнеса вывод практический: проверять нужно не наличие строки `max_budget`, а весь путь принятия решения — от идентификации клиента до надёжного счётчика и реакции при отказе инфраструктуры.
Что подтверждает официальная документация
LiteLLM описывает шлюз как центральный слой с аутентификацией, ограничением частоты, бюджетами и маршрутизацией. Данные о ключах, командах и расходах хранятся в PostgreSQL, а Redis используется для быстрых счётчиков и координации между экземплярами.
Для бюджетов важны четыре детали.
- Без подключённой базы данных расходы не с чем сопоставлять, поэтому настройка глобального бюджета работает в режиме fail-open: запросы продолжают выполняться.
- Резервирование бюджета включено по умолчанию. Перед запросом шлюз оценивает максимально возможную стоимость, временно резервирует её, отклоняет запрос при превышении лимита, а после ответа заменяет резерв фактической суммой.
- Если резервирование отключить, несколько одновременных запросов могут пройти проверку по старому значению и вместе превысить лимит.
- Для строгого потолка предусмотрен режим `fail_closed_budget_enforcement`. Он сверяет состояние с авторитетной БД; если расходы нельзя подтвердить ни через Redis, ни через базу, запрос отклоняется с ошибкой 503 вместо продолжения работы вслепую.
Отдельное ограничение касается пакетных задач. При отправке batch-запроса шлюз видит идентификатор входного файла, но не может заранее оценить полную стоимость всех промптов внутри. Окончательная сумма появляется после завершения задания. Значит, пакетный контур требует собственного лимита пропускной способности и контроля уже выполненных затрат.
Минимальная архитектура для компании
Рабочая схема выглядит так:
1. CRM, внутренний помощник, RAG и агенты обращаются не к провайдерам напрямую, а к единому шлюзу.
2. Каждому продукту или процессу выдаётся отдельный виртуальный ключ. Общий ключ «на весь офис» не позволяет расследовать перерасход и безопасно отключить один сценарий.
3. В PostgreSQL хранятся владельцы ключей, команды, лимиты и журнал расходов. База резервируется и восстанавливается так же серьёзно, как система учёта платежей.
4. Redis ускоряет счётчики и ограничение частоты. Если денежный потолок должен быть жёстким, поведение при недоступности Redis задают заранее и тестируют.
5. Секреты провайдеров остаются только в шлюзе или менеджере секретов. Приложения получают виртуальные ключи с минимальными правами и разрешённым набором моделей.
6. Метрики выгружаются во внешнее наблюдение: число запросов, токены, ошибки, задержка, отказы по лимиту и расхождение с фактическим счётом провайдера.
Такой слой полезен и для гибридной схемы. Один логический маршрут может направлять обычные запросы в локальную модель, сложные — во внешний API, а резервные — в другой контур. Но финансовый лимит не заменяет технические квоты: нужны одновременно RPM/TPM, ограничение параллелизма, максимальная длина ответа и правила доступных моделей.
Как считать локальные модели
Для облачного API стоимость обычно выводится из токенов и тарифной карты. Для локальной модели «нулевая цена токена» вводит в заблуждение: компания всё равно платит за GPU или CPU, электричество, хранение весов, простой резерва, администрирование и поддержку.
Поэтому внутреннюю цену полезно считать отдельно. Простейшая модель:
`стоимость часа контура / полезные токены за час × токены запроса`.
В стоимость часа включают аренду или амортизацию оборудования, энергию, резервирование и труд эксплуатации. Полезную производительность измеряют на реальной смеси запросов, а не на коротком синтетическом промпте. Если локальный маршрут и внешний API стоят за одним шлюзом, отчёт должен различать фактический платёж провайдеру и расчётную внутреннюю себестоимость.
Ещё одна ловушка — устаревшая тарифная карта. Документация LiteLLM рекомендует поддерживать данные о ценах моделей в актуальном состоянии. Финансовая сверка всё равно нужна: раз в день или неделю сравнивать расчёт шлюза со счётом поставщика по одинаковому периоду, моделям и типам токенов, включая кешированные и служебные категории.
Где чаще всего ломается контроль
Первый риск — одинаковый ключ у нескольких приложений. Ограничение срабатывает, но бизнес не понимает, какой процесс остановить. Второй — мягкий лимит на дашборде без теста конкурентной нагрузки. Третий — зависимость только от денежной оценки: длинный ответ или неограниченный цикл агента может перегрузить систему раньше, чем исчерпает месячный бюджет.
Нужно учитывать и семантику отказа. Для тестового помощника временный fail-open может быть приемлем, если важнее доступность. Для агента, который способен массово запускать дорогие операции, лучше отказать при невозможности проверить остаток. Это управленческое решение, а не значение по умолчанию библиотеки.
Наконец, бюджет не является средством защиты данных. Шлюзу всё равно нужны разграничение ролей, журнал административных действий, маскирование чувствительных полей и запрет на запись промптов по умолчанию там, где они содержат персональные или коммерческие сведения.
Модельный расчёт пилота
Предположим, три внутренних AI-сервиса вместе выполняют 120 000 запросов в месяц. Средняя расчётная стоимость одного запроса — 0,9 рубля, но 5% запросов из-за длинного контекста стоят в среднем 9 рублей. Тогда базовая месячная сумма составляет около 156 600 рублей:
- 114 000 обычных запросов × 0,9 рубля = 102 600 рублей;
- 6 000 тяжёлых запросов × 9 рублей = 54 000 рублей.
Если ошибочный агент создаст ещё 10 000 тяжёлых запросов, добавка составит 90 000 рублей. Лимит на отдельный ключ и ограничение итераций остановят именно этот сценарий, не выключая остальные продукты. Это модельный пример, а не результат LiteLLM: реальные суммы зависят от тарифов, длины контекста, кеширования и доли локального инференса.
Пилот на две недели
В первую неделю достаточно подключить один некритичный сервис, выделить ему виртуальный ключ и собрать исходные данные без жёсткого блокирования. Нужны распределения стоимости и задержки, доля ошибок, пиковая параллельность и пять самых дорогих типов запросов.
Во вторую неделю вводят предупреждение на 70% лимита, мягкое ограничение на 90% и жёсткую остановку тестового ключа на 100%. Затем искусственно создают параллельный всплеск, недоступность Redis и разрыв соединения с БД. Проверяют не красивый график, а наблюдаемое поведение каждого режима.
Успех пилота измеряется четырьмя результатами:
- каждый расход привязан к продукту и владельцу;
- лимит выдерживает конкурентную нагрузку;
- отказ хранилища приводит к заранее выбранному поведению;
- расчёт шлюза регулярно сверяется с внешним счётом и внутренней себестоимостью.
LLM-шлюз превращает потребление моделей в управляемый сервис только тогда, когда счётчик, хранилище и политика отказа образуют единую систему. Конфигурация без этой системы создаёт ощущение контроля — а оно обычно обходится дороже самого токена.