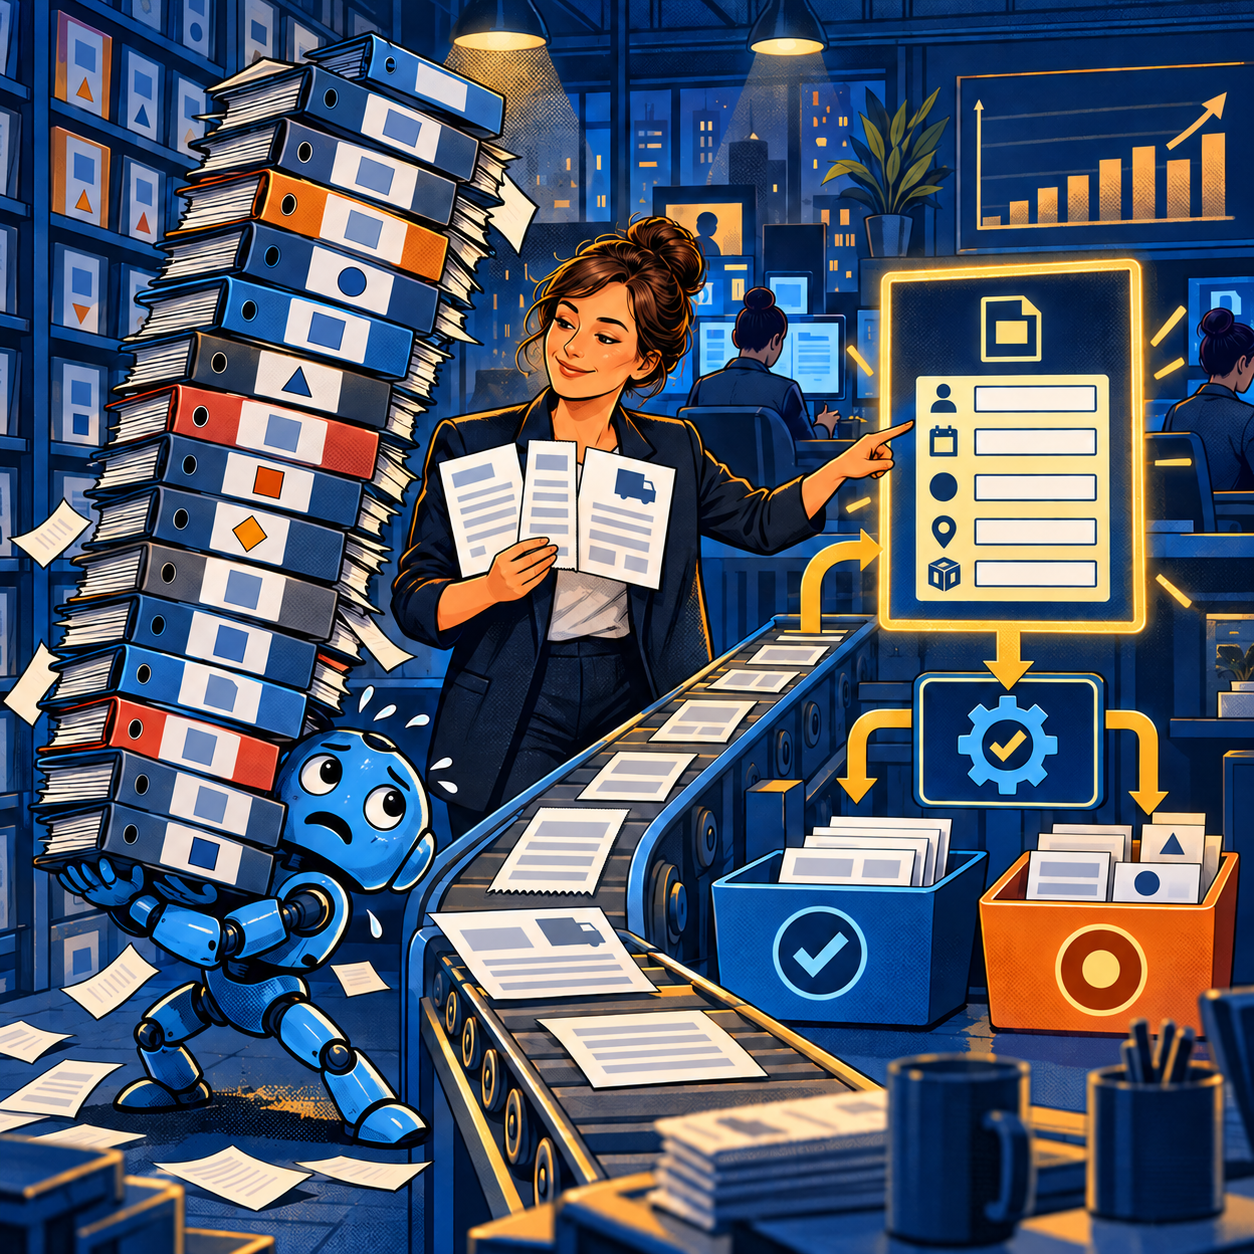
Где была дорогая часть процесса
Affinda разрабатывает системы интеллектуальной обработки документов: из счетов, анкет и других неструктурированных файлов они извлекают поля, которые затем могут попасть в учётную систему или другой бизнес-процесс. В опубликованном AWS кейсе компания описывает прежний подход: под новые типы документов и схемы приходилось дообучать открытые модели, готовить разметку и привлекать инженеров.
Проблемой была не только стоимость одного запуска модели. Дорого обходилось появление каждого нового сценария: согласовать поля, собрать примеры, разметить данные, настроить модель, проверить качество и снова подключить разработчика при изменении формы.
Affinda перевела часть конвейера на большие языковые модели в Amazon Bedrock. В источнике перечислены Claude Sonnet 3.5 V2, Claude 3.7 Sonnet и Claude Sonnet 4. Новая система использует асинхронные вызовы, сохраняет гибрид старых и генеративных моделей и работает поверх существующего облачного контура компании с EKS, EC2, SageMaker и CloudFormation. Обновлённую платформу начали разворачивать у клиентов в конце 2024 года.
Главное изменение процесса: вместо отдельного обучения под каждую схему команда задаёт структуру ответа и показывает модели небольшое число характерных примеров в контексте. Корректировки можно описывать естественным языком, поэтому часть настройки переходит от ML-инженера к специалисту по внедрению или владельцу процесса.
Результат — заявление компании, а не универсальный норматив
По данным самой Affinda, время настройки нового сценария извлечения сократилось на 90%, а затраты команды внедрения — также на 90%. Компания говорит, что конфигурация, занимавшая недели или месяцы, в некоторых случаях стала доступна пользователям за минуты.
Эти цифры опубликованы AWS как история клиента и основаны на сообщении участника проекта. В карточке нет исходного числа часов, объёма документов, распределения типов полей, тестовой выборки, точности до и после изменения и независимого аудита. Поэтому 90% нельзя переносить в бюджет другой компании как ожидаемую экономию.
Полезен более узкий вывод: генеративное извлечение способно уменьшить стоимость запуска нового шаблона, когда основная статья затрат — ручная разметка и инженерная настройка отдельной модели. Сработает ли это на накладных, актах или договорах конкретной компании, решает только тест на её документах.
Воспроизводимая архитектура без привязки к облаку
Принцип Affinda не требует копировать весь стек AWS. Его можно проверить с защищённым API или локальной моделью, если она достаточно хорошо читает нужный язык, таблицы и формат документов.
Рабочий конвейер разумно разделить на этапы:
1. Приём файла с антивирусной проверкой, ограничением размера и идентификатором операции.
2. Извлечение текста и структуры: OCR для сканов, координаты блоков, номера страниц и таблицы.
3. Определение типа документа и выбор версии схемы.
4. Детерминированное извлечение там, где правило надёжно: штрихкод, ИНН, номер по регулярному выражению, итоговая сумма из известного поля.
5. LLM или VLM получает документ, JSON Schema и несколько проверенных примеров сложных случаев.
6. Результат проходит синтаксическую и бизнес-валидацию.
7. Сомнительные записи уходят в очередь человеку; принятые изменения записываются в целевую систему идемпотентно.
8. Исправление оператора сохраняется как новый тестовый пример, но не меняет продуктивную конфигурацию без проверки.
Ollama поддерживает структурированный ответ по JSON Schema и рекомендует валидировать его типизированной моделью. llama.cpp умеет ограничивать генерацию грамматикой и преобразовывать поддерживаемое подмножество JSON Schema в GBNF. Это снижает риск сломанного JSON, но не доказывает истинность значения: правильно оформленная сумма всё ещё может быть взята не из той строки.
Схема — это контракт, а не подсказка
До выбора модели нужно описать каждый выходной атрибут:
- точное имя и тип;
- обязательность и допустимое значение `null`;
- формат даты, валюты и десятичного разделителя;
- список допустимых категорий;
- правило нормализации;
- ссылка на страницу и фрагмент-основание;
- причина, по которой поле отправляется на проверку.
Для финансового документа недостаточно получить `total: 125000`. Нужны валюта, НДС, исходное написание, координаты или цитата и версия схемы. Затем обычный код проверяет равенство суммы строк итогу, период, контрагента, дубликаты номера и соответствие справочникам.
Закрытая схема с запретом лишних полей помогает обнаружить неожиданный вывод. Версионирование защищает интеграцию: старая форма продолжает обрабатываться по прежнему контракту, пока новая версия проходит тесты.
Как выбирать несколько примеров
Few-shot настройка не означает «положить в промпт первые три документа». Нужны идиоматические примеры, которые показывают реальную неоднозначность процесса:
- один обычный документ;
- один файл с отсутствующим необязательным полем;
- один сложный макет или таблица;
- пример исправления типичной ошибки;
- явный случай, когда система должна отказаться от автоматического ответа.
Примеры становятся частью конфигурации и требуют тех же владельцев, версий и проверки, что правила в обычной программе. Нельзя автоматически добавлять любое исправление пользователя: единичная ошибка оператора или необычный документ может ухудшить весь класс.
Длинный набор демонстраций также расходует контекст и вычисления. Исследования по извлечению информации показывают, что эффект few-shot зависит от поля и задачи; дополнительные примеры увеличивают входной объём. Поэтому число примеров выбирают экспериментом, а не максимизируют.
Что оставить классическим алгоритмам
Гибридная архитектура из кейса особенно важна. Генеративная модель не обязана заменять всё. Стабильные штрихкоды, контрольные суммы, справочники, математические связи и известные координаты дешевле и надёжнее обрабатывать обычным кодом или специализированным OCR.
LLM полезна для вариативных названий, новых макетов, разорванного контекста и объяснения, почему значение относится к нужному полю. Финальное решение о записи в ERP должно принадлежать валидатору и правилам процесса.
Дообученная модель сохраняет смысл при очень большом стабильном потоке, жёстких ограничениях задержки, устойчивой разметке или недостаточном качестве базовой модели. Few-shot подход выигрывает прежде всего скоростью появления новых схем.
Локальный контур: что он меняет
Для российских компаний конкретный облачный набор Affinda не является готовым рецептом. Но тот же контракт можно поставить перед локальной моделью через Ollama, llama.cpp или другой совместимый inference-сервер.
Локальный вариант уменьшает передачу документов за пределы управляемого контура и упрощает контроль хранения. Взамен компания получает ответственность за GPU или CPU, обновления, доступность, журналирование, резервирование и проверку лицензии выбранной модели.
Минимальное разделение данных:
- оригиналы — в существующем защищённом хранилище;
- модель получает только необходимые страницы или изображения;
- промпты, примеры и схемы версионируются без персональных данных там, где это возможно;
- журнал хранит хеш документа, версию модели и схемы, результат валидаторов и решение человека;
- тестовый контур не имеет права записывать изменения в продуктивные системы.
Нужно учитывать и prompt injection: документ может содержать текст, который пытается переопределить инструкцию. Содержимое файла следует считать данными, а не командой. Модель не должна иметь произвольных инструментов, а выход проходит строгую схему и бизнес-правила.
Что измерять в пилоте
Для первой проверки достаточно выбрать один тип документа и 100–300 обезличенных файлов, включая редкие и плохие сканы. Это модельный диапазон для пилота, а не вывод из кейса Affinda.
Разделите набор на настройку и отложенный тест. Сравните три варианта:
- текущую ручную обработку;
- существующий шаблон, OCR или дообученную модель;
- LLM со схемой и небольшим числом примеров.
Считать нужно качество по каждому полю, долю документов без ручного вмешательства, долю ложной автоматической записи, время оператора на исключение, p95 задержки и стоимость одного принятого документа. Отдельно проверьте новые макеты, таблицы, рукописные исправления, пустые поля, несколько валют и повторную загрузку одного файла.
Критический показатель — straight-through processing при согласованной границе ошибок. Система, которая автоматически проводит 60% документов и отправляет остальные человеку, может быть ценнее модели с высокой средней метрикой и редкими дорогими ошибками.
Модель экономики
Сначала зафиксируйте стоимость запуска нового сценария сегодня:
`разметка + часы ML/интеграции + тестирование + исправления + сопровождение`.
После пилота сравните её со стоимостью схемы и примеров:
`анализ полей + подготовка примеров + inference + проверка исключений + регресс-тесты`.
Годовой эффект складывается из числа новых схем, объёма документов и сокращения ручной работы. Из него вычитаются инфраструктура, лицензии, наблюдаемость, контроль качества и стоимость ошибочных записей. Если новый тип появляется раз в несколько лет, 90-процентное сокращение настройки может быть менее важно, чем цена каждого inference. При десятках новых форм в квартал ситуация обратная.
Что взять руководителю
Кейс Affinda показывает, где генеративный ИИ может менять экономику: не обязательно в цене обработки одного документа, а в скорости настройки следующей схемы. Повторять стоит не название облака, а управляемый конвейер — структура ответа, несколько эталонных примеров, детерминированные проверки и очередь исключений человеку.
Практический следующий шаг — выбрать один дорогой в настройке тип документа, собрать отложенный тест и за неделю сравнить текущий метод с локальной или защищённой LLM. Решение о масштабировании принимайте по стоимости принятого документа и ошибочной автоматической записи, а не по заявленным 90% из чужого кейса.